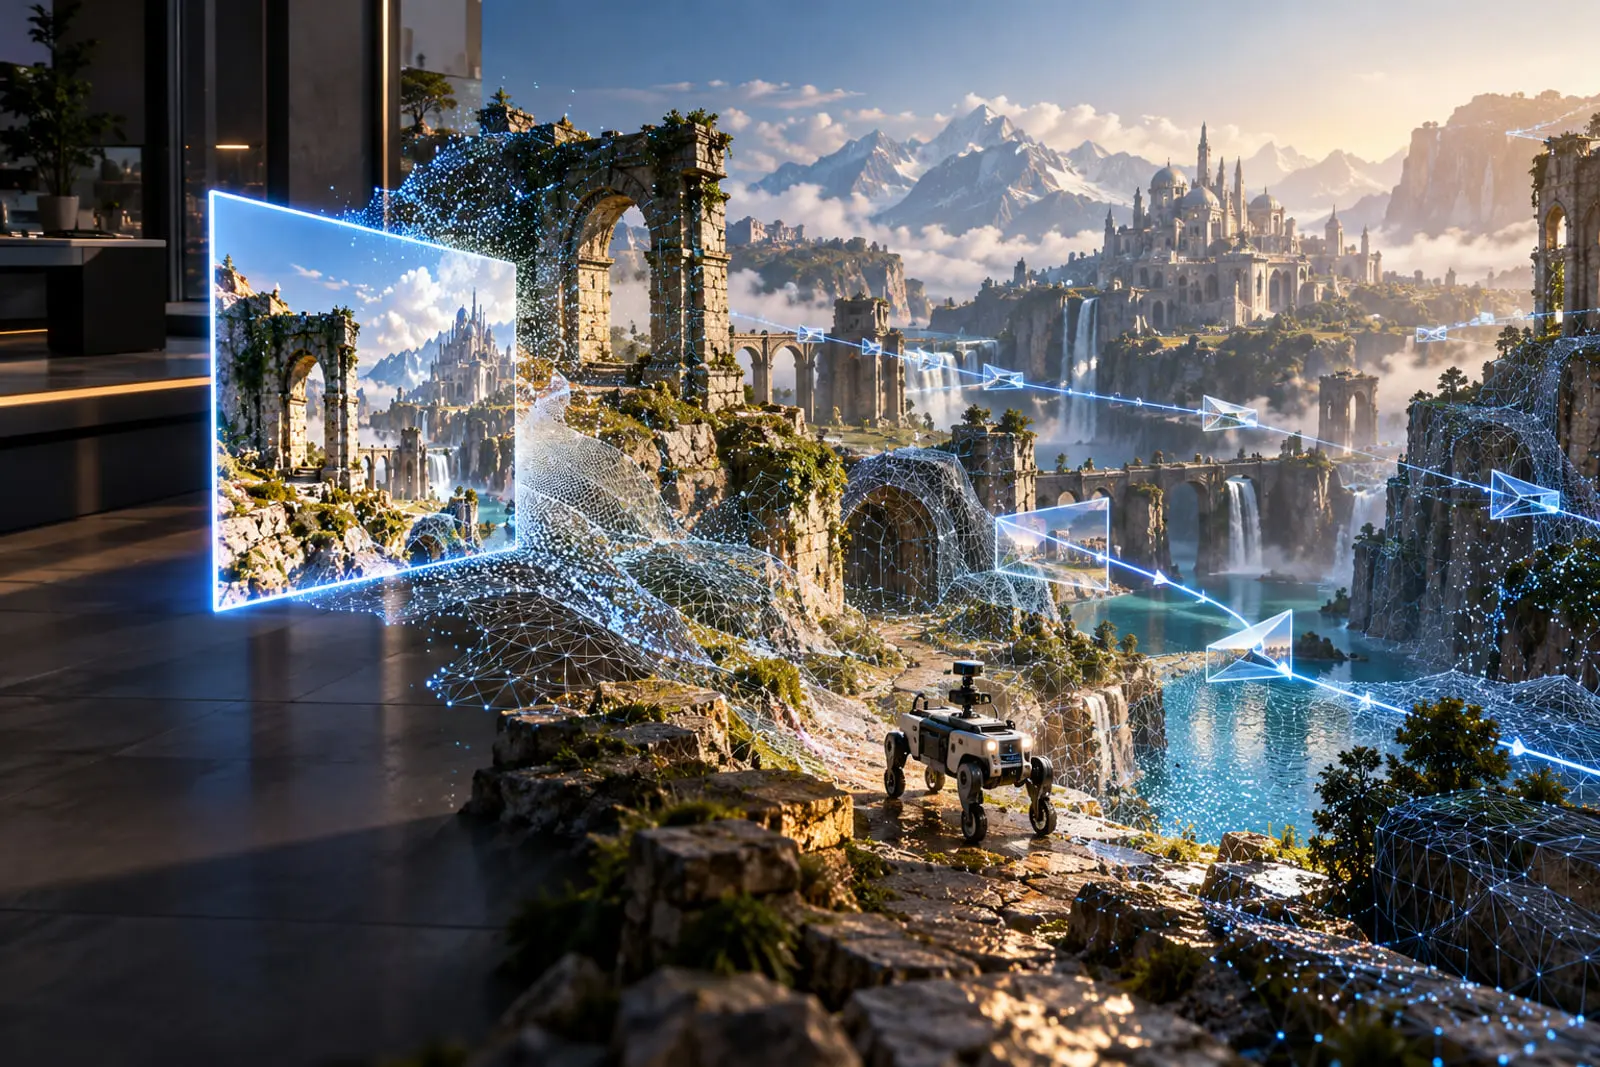
تماشای یک تصویر ثابت و قدمزدن درون جزئیات نامحدود آن، همواره یکی از رویاهای کهن در حوزهی گرافیک و هوش مصنوعی بوده است. اکنون پژوهشگران انویدیا با معرفی مدل متنباز Lyra 2.0 این چشمانداز را به واقعیتی تعاملی بدل ساختهاند؛ ابزاری که میتواند تنها بر پایهی یک تصویر ورودی یا اعلان متنی، جهانهای سهبعدیِ پیوسته، قابل گردش و بینهایت خلق کند.
بر اساس بیانیهی انویدیا، پروژهی Lyra 2.0 که برای ارائه در رویداد SIGGRAPH Asia 2026 پذیرفته شده، با رفع دو چالش بنیادین در مدلهای ویدئویی یعنی فراموشی مکانی و انحراف زمانی، امکان بازتولید فضاهای سهبعدی در مقیاس وسیع را فراهم میآورد. کدهای رابط کاربری، وزنهای مدل و حتی اسکریپتهای آموزش بهطور کامل و رایگان روی گیتهاب و هاگینگ فیس منتشر شدهاند.
روشهای پیشینِ تولید ویدئو هنگام جابهجایی طولانی دوربین با افت کیفیت شدیدی روبهرو میشدند. وقتی کاربر پس از گشتوگذار در محیط به نقطهی ابتدایی بازمیگشت، مدل به دلیل محدودیت حافظهی زمانی، جزئیات گذشته را فراموش میکرد و ساختار متفاوتی را پدید میآورد. تجمع خطاهای کوچک در گذر زمان نیز به اعوجاج هندسی و بصری کل صحنه ختم میشد.
پژوهشگران برای حل مسئلهی فراموشی مکانی، هندسهی سهبعدی هر فریم را نگهداری میکنند و از آن برای مسیریابی دادهها، فراخوانی فریمهای پیشین و تطبیق دقیق زاویهی دید با معماری DiT بهره میگیرند. آموزش مدل با تاریخچههای خودافزوده سبب میشود که سیستم بهجای تکثیر خطا، انحرافهای زمانی را بهصورت خودکار برطرف کند.
خروجیهای حاصل از این سازوکار تنها ویدئوهای نمایشی گذرا نیستند، بلکه به ساختارهای موسوم به 3DGS (توزیع گاوسی سهبعدی) و مشهای بهینهسازیشده تبدیل میشوند. چنین دادههایی قابلیت انتقال مستقیم به موتورهای فیزیکی نظیر Isaac Sim را دارند تا بستری واقعگرایانه برای آموزش رباتهای هوشمند و ناوبری رباتیک فراهم شود.
انتشار ابزار تقطیر 4-step DMD distillation LoRA فرایند استنتاج و ساخت صحنه را بهمراتب پرسرعتتر کرده است. کاربران در رابط کاربری تعاملی میتوانند مسیر دوربین را آزادانه تعیین کنند، به فضاهای کشفنشده بروند یا بارها به بخشهای قبلی سر بزنند بدون آنکه یکپارچگی هندسهی صحنه فرو بریزد.