فناوری تولید گفتار مصنوعی از مرحلهی خوانش خشک متون فراتر رفته و وارد دورانی شده که در آن هوش مصنوعی توانایی ایفای نقش و صداسازی پویا را پیدا کرده است. گوگل در همین راستا با معرفی دو عضو جدید از خانوادهی مدلهای زبانی خود، بستری فراهم آورده است که سیستم تولید صوت را به یک استودیو خلاقانه و تعاملی بدل میسازد.
دو مدل Gemini 3.8 Flash TTS و Gemini 3.8 Flash-Lite TTS بهمنظور پاسخگویی به نیازهای پیشرفتهی بازیسازان، پادکسترها و توسعهدهندگان تجاری عرضه شدهاند. رونمایی از مدلهای یادشده پس از توسعهی فناوریهایی چون Gemini 3.5 Live Translate و Gemini 3.8 Live گامی کلیدی در تکمیل سبد محصولات صوتی گوگل بهشمار میرود.
مدل Gemini 3.8 Flash TTS برای هدایت دقیق دیالوگها و خلق صداهای منحصربهفرد از پایه طراحی شده است. کاربران میتوانند با تکیه بر پرامپتهای متنی ساده، لحن، لهجه و ویژگیهای شخصیتی متعددی را در بیش از ۱۰۰ زبان زنده و گویش گوناگون ایجاد کنند. کنترل جزئیاتی نظیر مکثها، تغییر ناگهانی لحن و صداهای غیرکلامی مانند خنده، نفسنفس زدن یا تصدیقهای کلامی سبب شده است خروجی نهایی شباهت فراوانی به اجرای یک بازیگر واقعی پیدا کند.
برخی از برجستهترین ویژگیها شامل موارد زیر هستند:
- طراحی مولد صدا: امکان ایجاد صداهای بدیع برای کاراکترهای فانتزی یا راویان داستان با فرمانهای متنی ساده.
- آرشیو گسترده: دسترسی به بیش از ۲٬۰۰۰ صدای بهینهسازیشده برای تولید محتوا با پشتیبانی از لهجههای بومی مثل اسپانیایی مکزیکی و فرانسوی کبکی.
- تنظیم و بازترکیب: قابلیت دستکاری زیروبمی صدا، سرعت بیان و چگالی لهجه در نسخههای آتی.
- اجرای همزمان دو گوینده: مدیریت مکالمات چندنفره از روی یک متن واحد بدون تداخل صدایی.
توسعهدهندگان در مدل جدید توانایی بازآفرینی پروفایلهای صوتی را تنها با دریافت یک فایل صوتی ۳۰ ثانیهای بهدست آوردهاند. حفظ اصالت و جلوگیری از سوءاستفادههای احتمالی دغدغهی اصلی مهندسان در پیادهسازی چنین امکانی بوده است. سیستم شبیهسازی برای جلوگیری از جعل هویت، به تأیید کلامی رضایت صاحب صدا پیش از آغاز فرایند متکی خواهد بود.
تمامی قطعات صوتی تولیدشده توسط مدلهای جدید بهصورت نامحسوس با فناوری واترمارک SynthID نشانهگذاری میشوند تا شناور بودن محتوا در بستر استانداردهای C2PA قابل ردیابی باشد. اعمال این تدابیر شفافیت محتوای تولیدی را تضمین کرده است و مانع از انتشار اطلاعات نادرست در بسترهای عمومی خواهد شد.
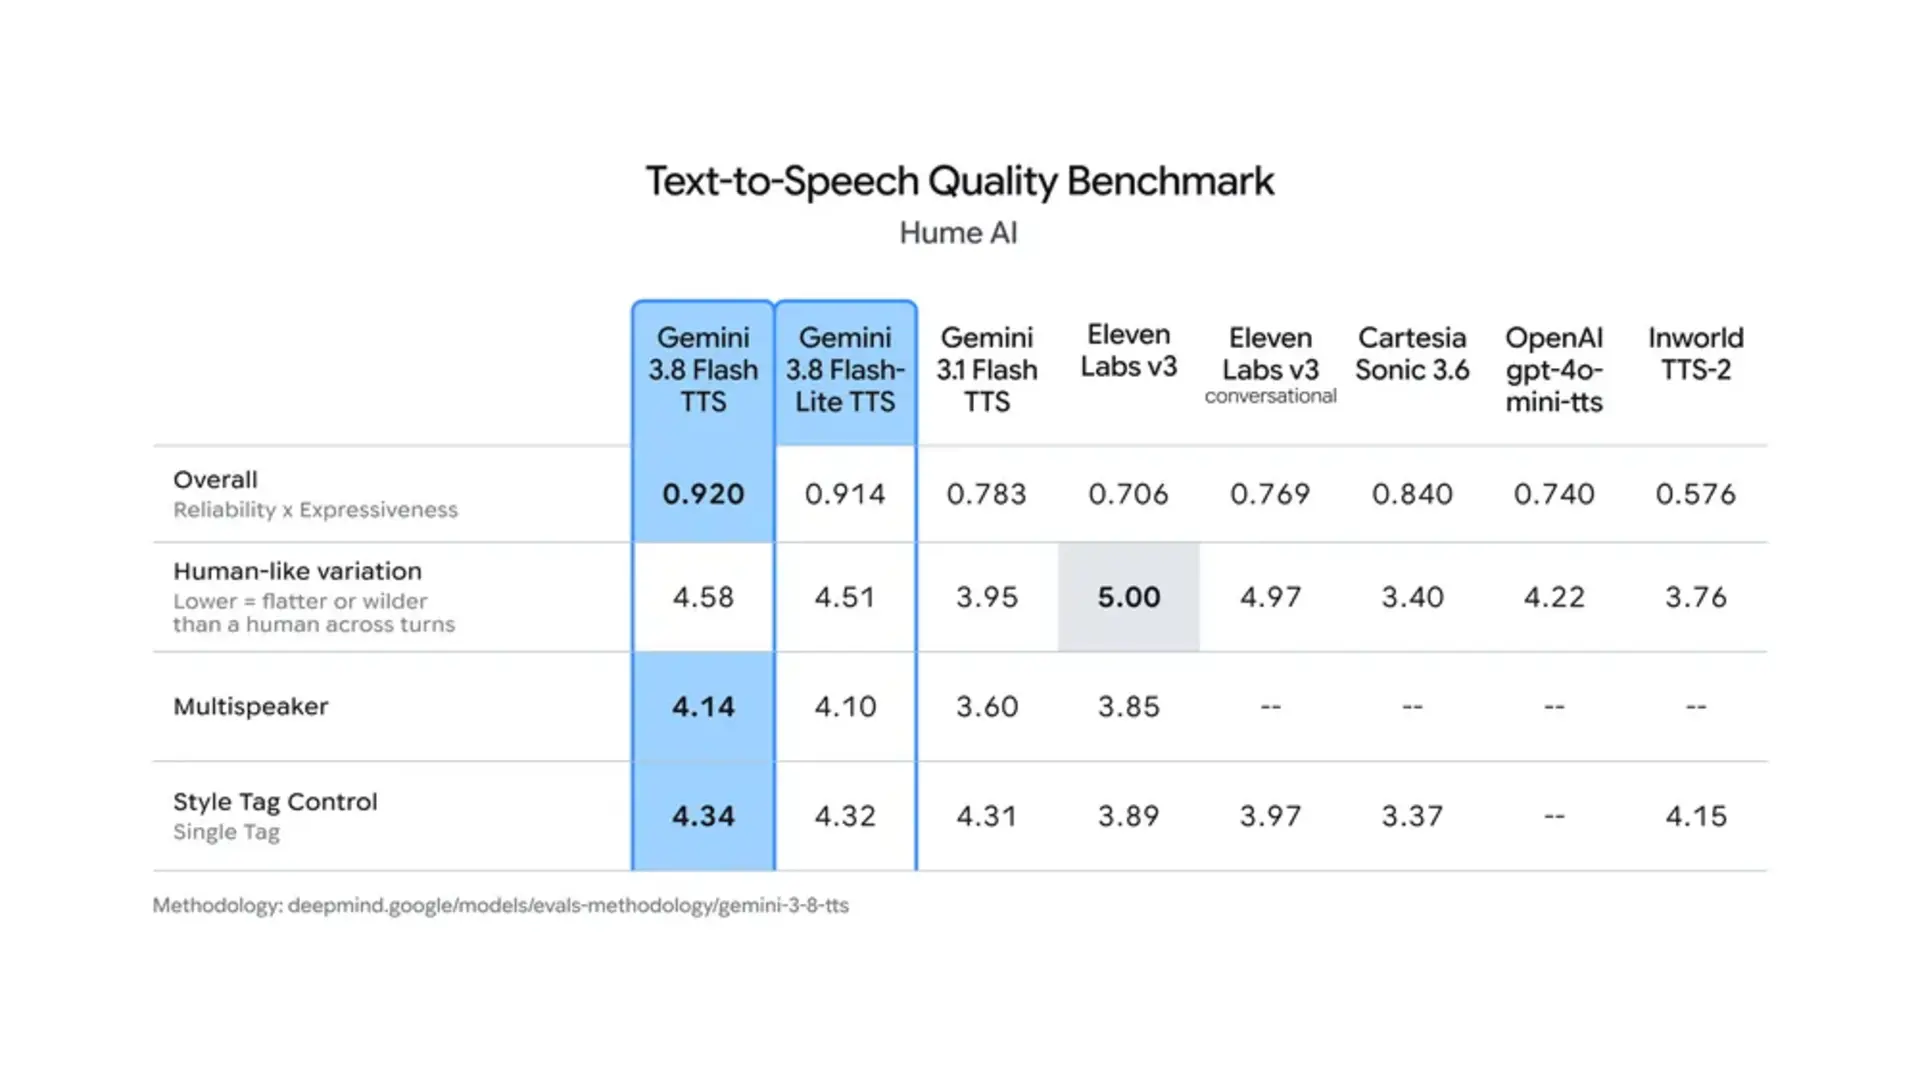
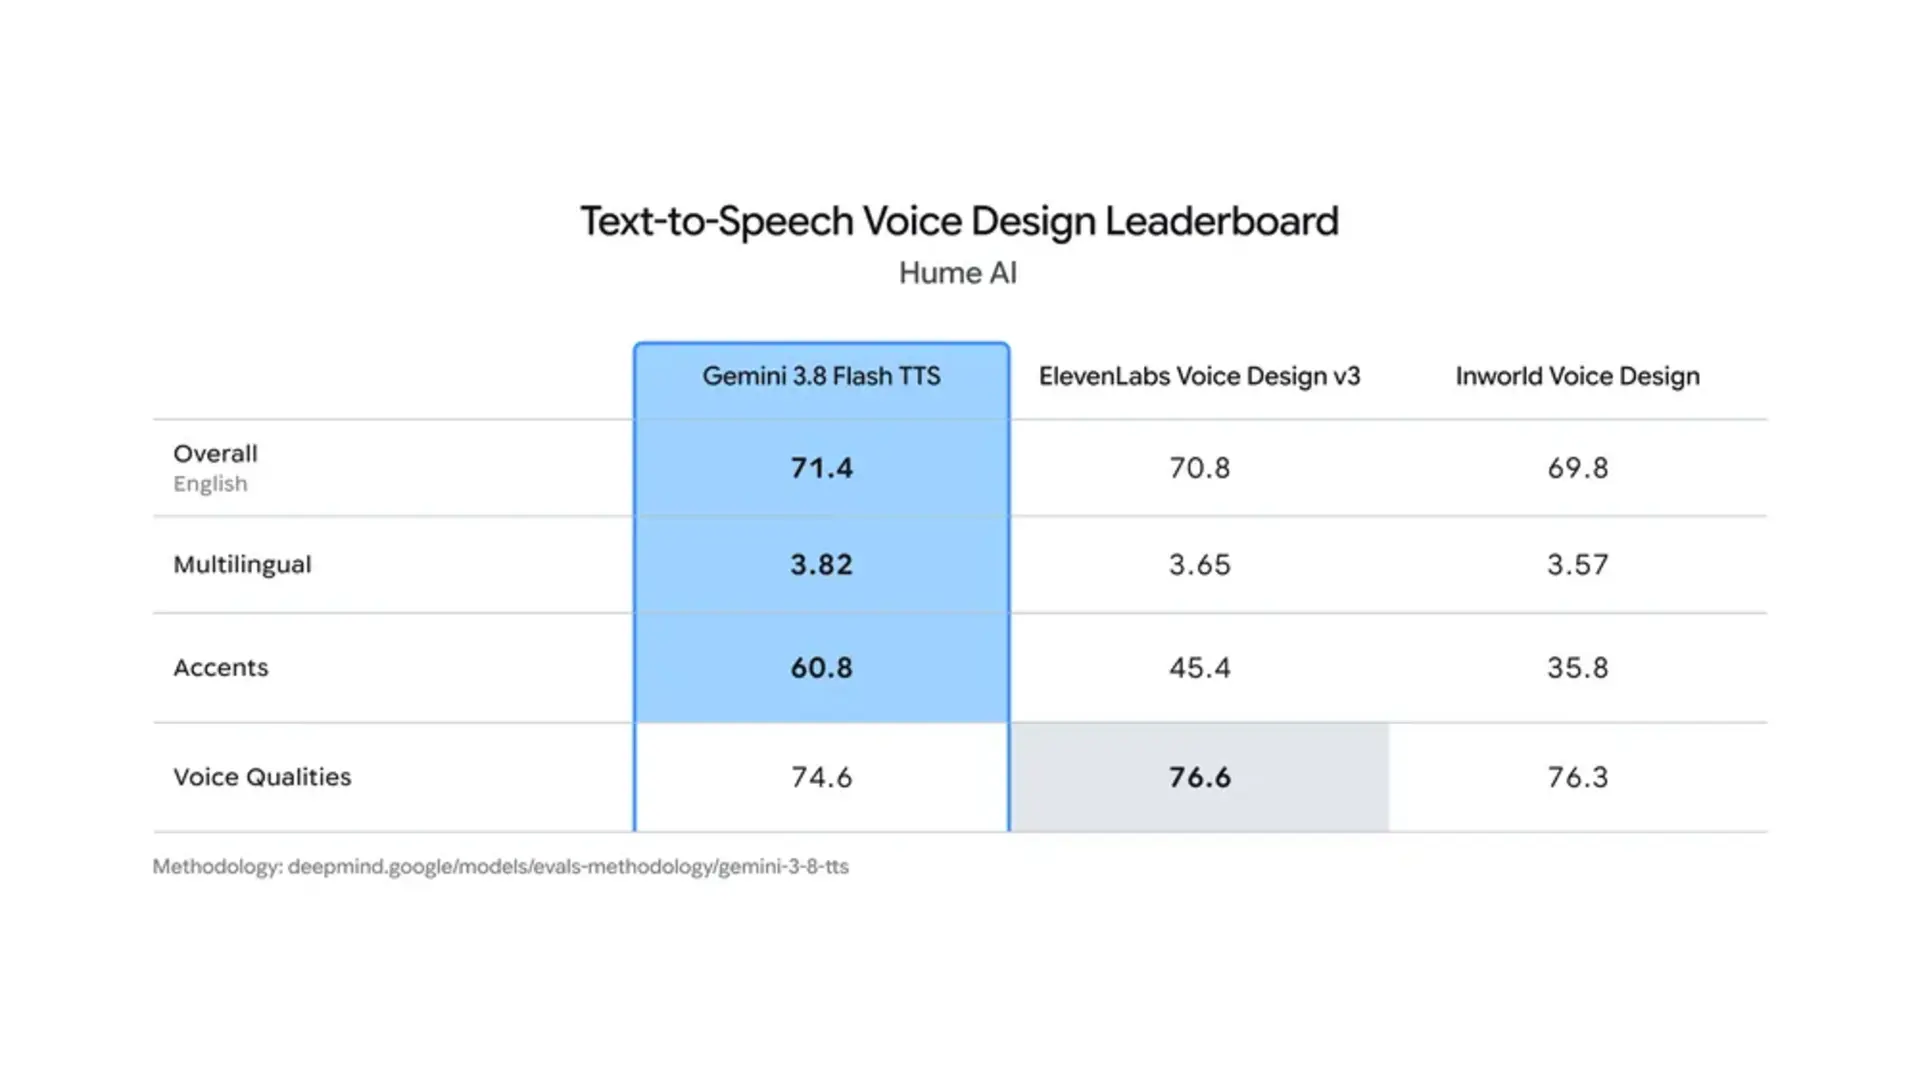
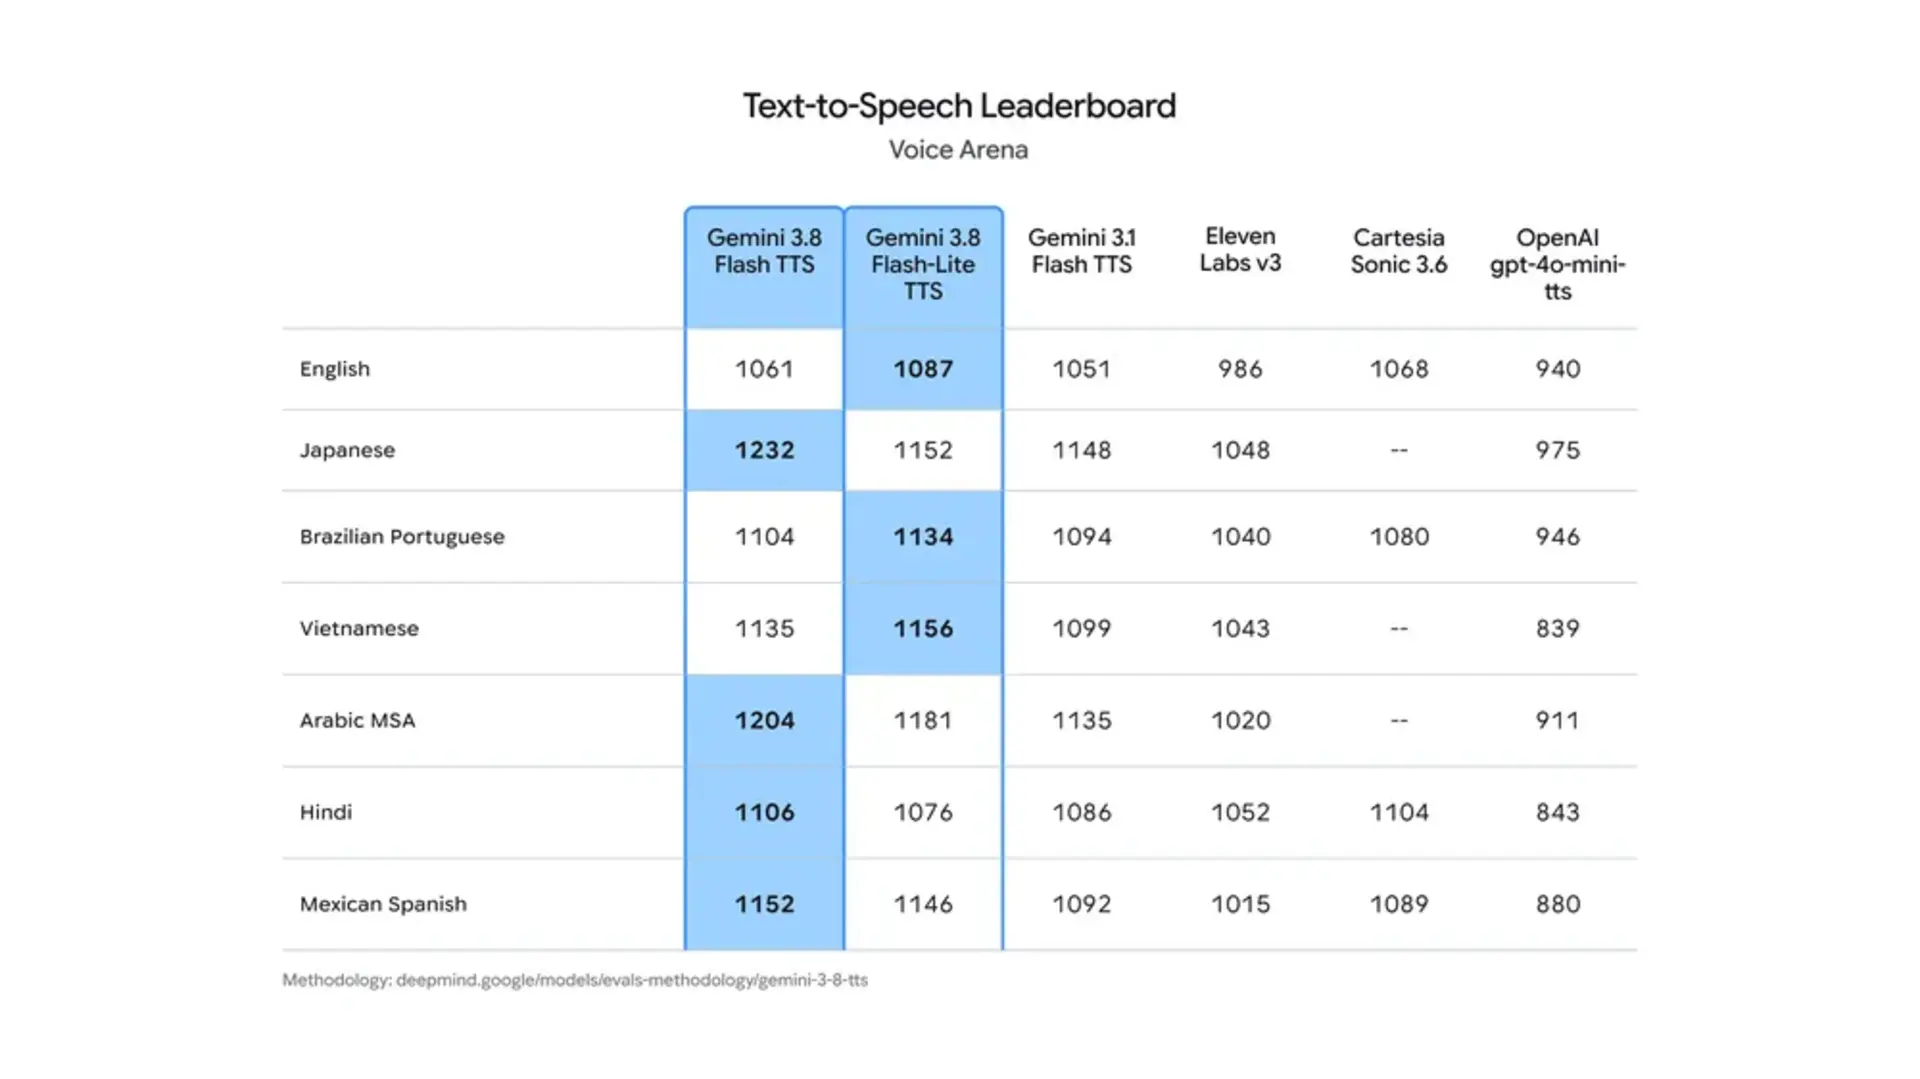
مدل Gemini 3.8 Flash TTS در آزمونهای تخصصی Hume AI با کسب امتیاز ۷۱٫۴ در جایگاه نخست شاخص طراحی صدا قرار گرفت و در بخش مدلسازی لهجهها امتیاز ۶۰٫۸ را بهثبت رساند. در ارزیابی جامع کیفیت، دو مدل جدید گوگل رتبههای اول و دوم جدول را تصاحب کردند که نشاندهندهی برتری محسوس آنها در تولید صوت طولانیمدت در مقایسه با Gemini 3.1 Flash TTS خواهد بود.
مدل اقتصادیتر یعنی Gemini 3.8 Flash-Lite TTS برای پروژههای با حجم بالا مانند دوبلهی خودکار و دستیارهای هوشمند پرسرعت بهینهسازی شده است. پلتفرمهای محبوبی نظیر Vercel و LiveKit و HeyGen و Figma ادغام این مدلها را در ساختار ابزارهای خود آغاز کردهاند تا تولید محتوای صوتی چندزبانه را برای کاربرانشان سریعتر از گذشته پیش ببرند.
امکانات جدید هماکنون در محیط آزمایشی Google AI Studio و از طریق رابطهای برنامهنویسی اختصاصی در دسترس قرار دارند. کاربران سرویسهای داخلی گوگل نیز میتوانند از مدلهای یادشده در Gemini Notebook و سرویس تولید ویدیوی Google Vids بهرهمند شوند.