میدان رقابت مدلهای هوش مصنوعی وارد مرحلهای تازه شده که در آن، توانایی پایداری در انجام محاسبات طولانیمدت و خودآزمایی نتایج، اهمیت دوچندانی یافته است. جدیدترین دستاورد در این مسیر با نام Grok 4.7 رونمایی شده تا پاسخگوی نیاز توسعهدهندگان و پژوهشگرانی باشد که با پروژههای سنگین کدنویسی و تحلیل دادههای پیچیده سر و کار دارند.
مدل گراک ۴٫۷ توانمندترین سامانهی ارائهشده توسط استارتاپ اسپیسایکسایآی ایلان ماسک برای امور برنامهنویسی و کارهای دانشمحور محسوب میشود. توسعهدهندگان در جریان طراحی نسخهی جدید، تمرکز ویژهای بر افزایش تابآوری مدل در انجام وظایف چندساعته، بررسی دقیق خروجیها و پیادهسازی متوازنترین سازوکارهای حفاظتی داشتهاند. همزمان با ارتقاء فنی، قیمت و سرعت اجرای مدل نسبت به Grok 4.6 بدون تغییر باقی مانده تا جایگاه رقابتی آن در بازار حفظ شود.
تغییرات بنیادین مدل بر پایهی یک مدل اولیهی حجیمتر در مقایسه با نسل پیشین شکل گرفتهاند. فرآیند آموزشGrok 4.7 با دورههای طولانیترِ یادگیری تقویتی همراه بوده و دادههای ورودی به سمت مسائلی سوق داده شدهاند که تکمیل آنها نیازمند ساعتها تفکر و پردازش مداوم است.
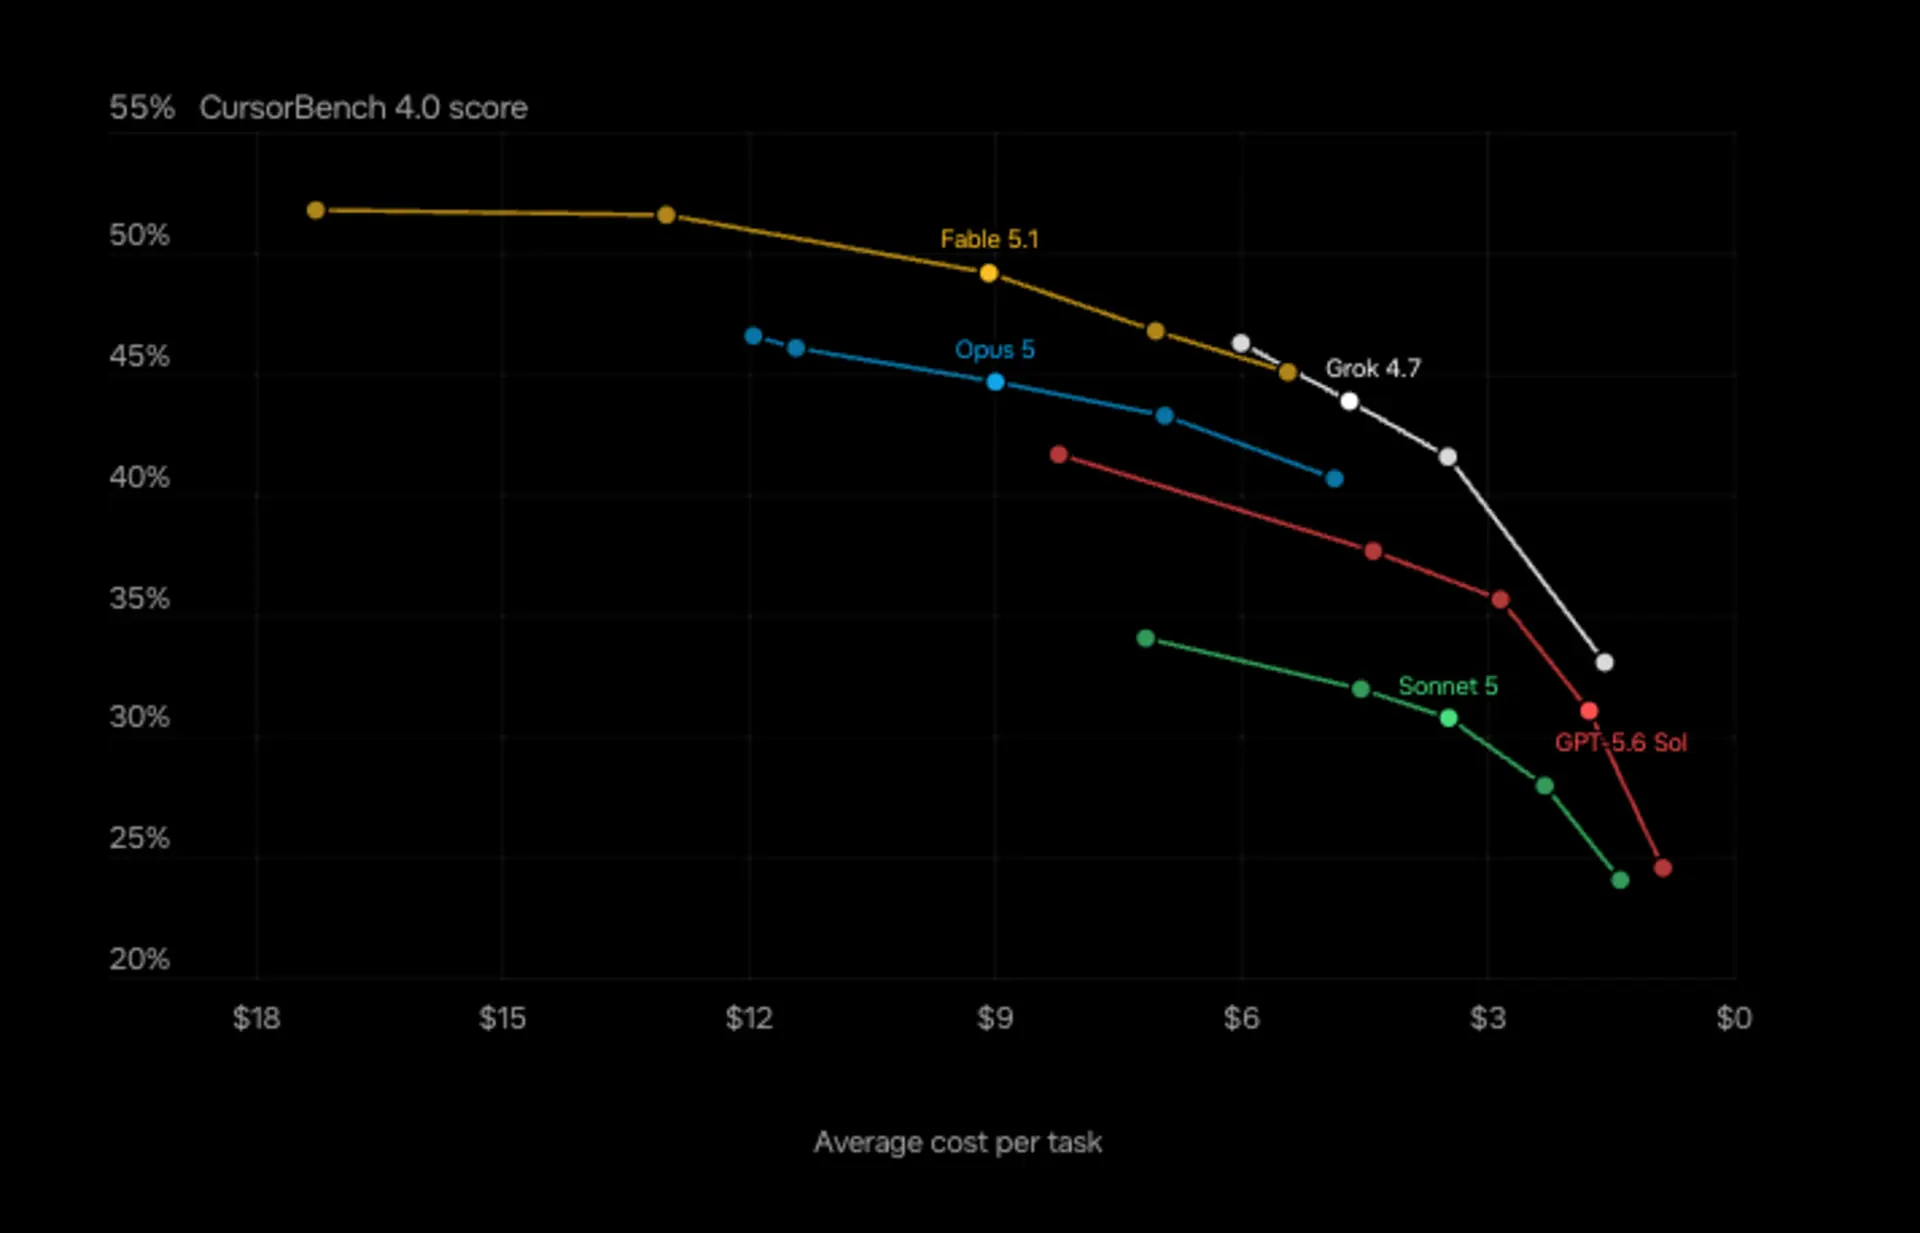
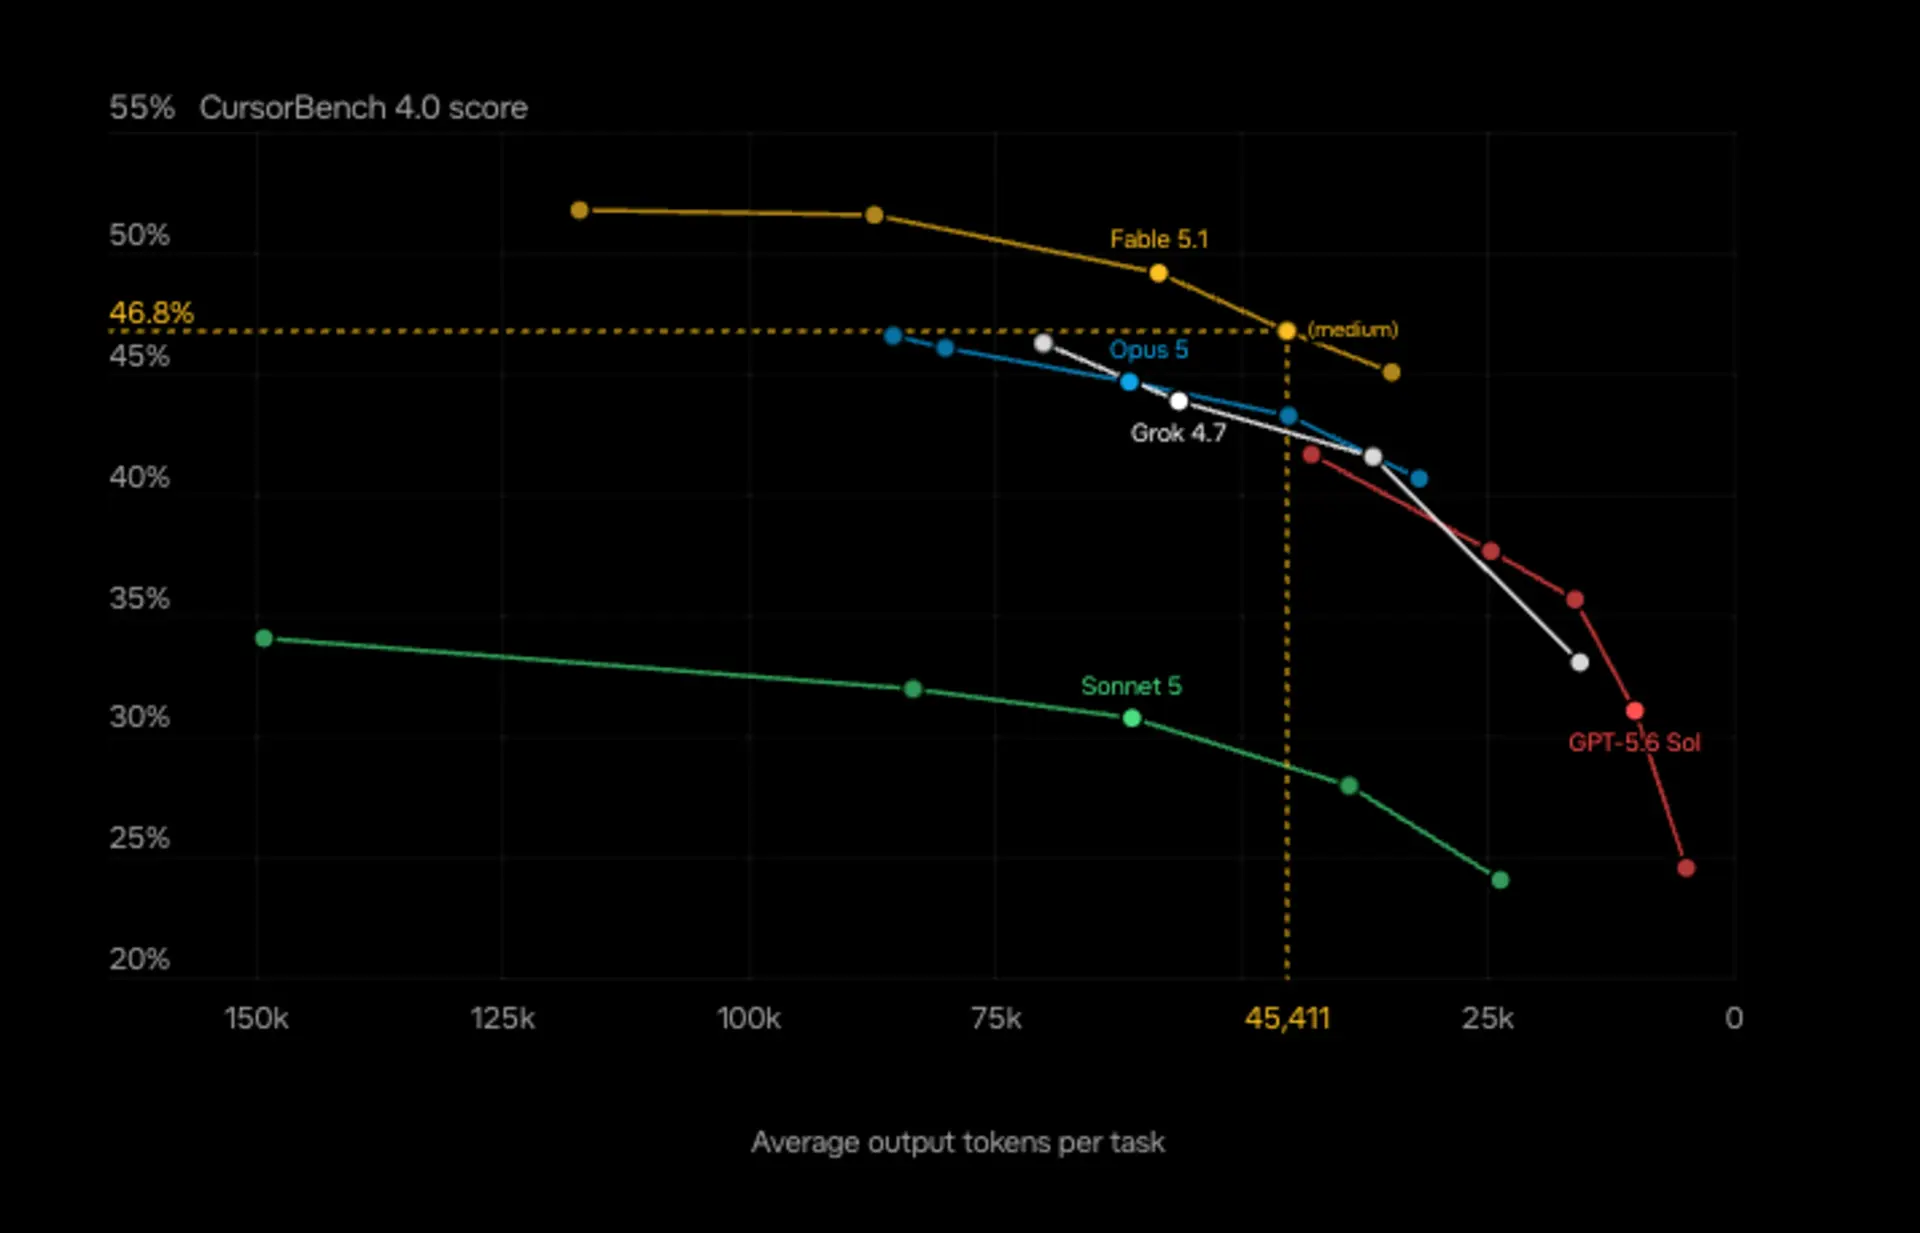
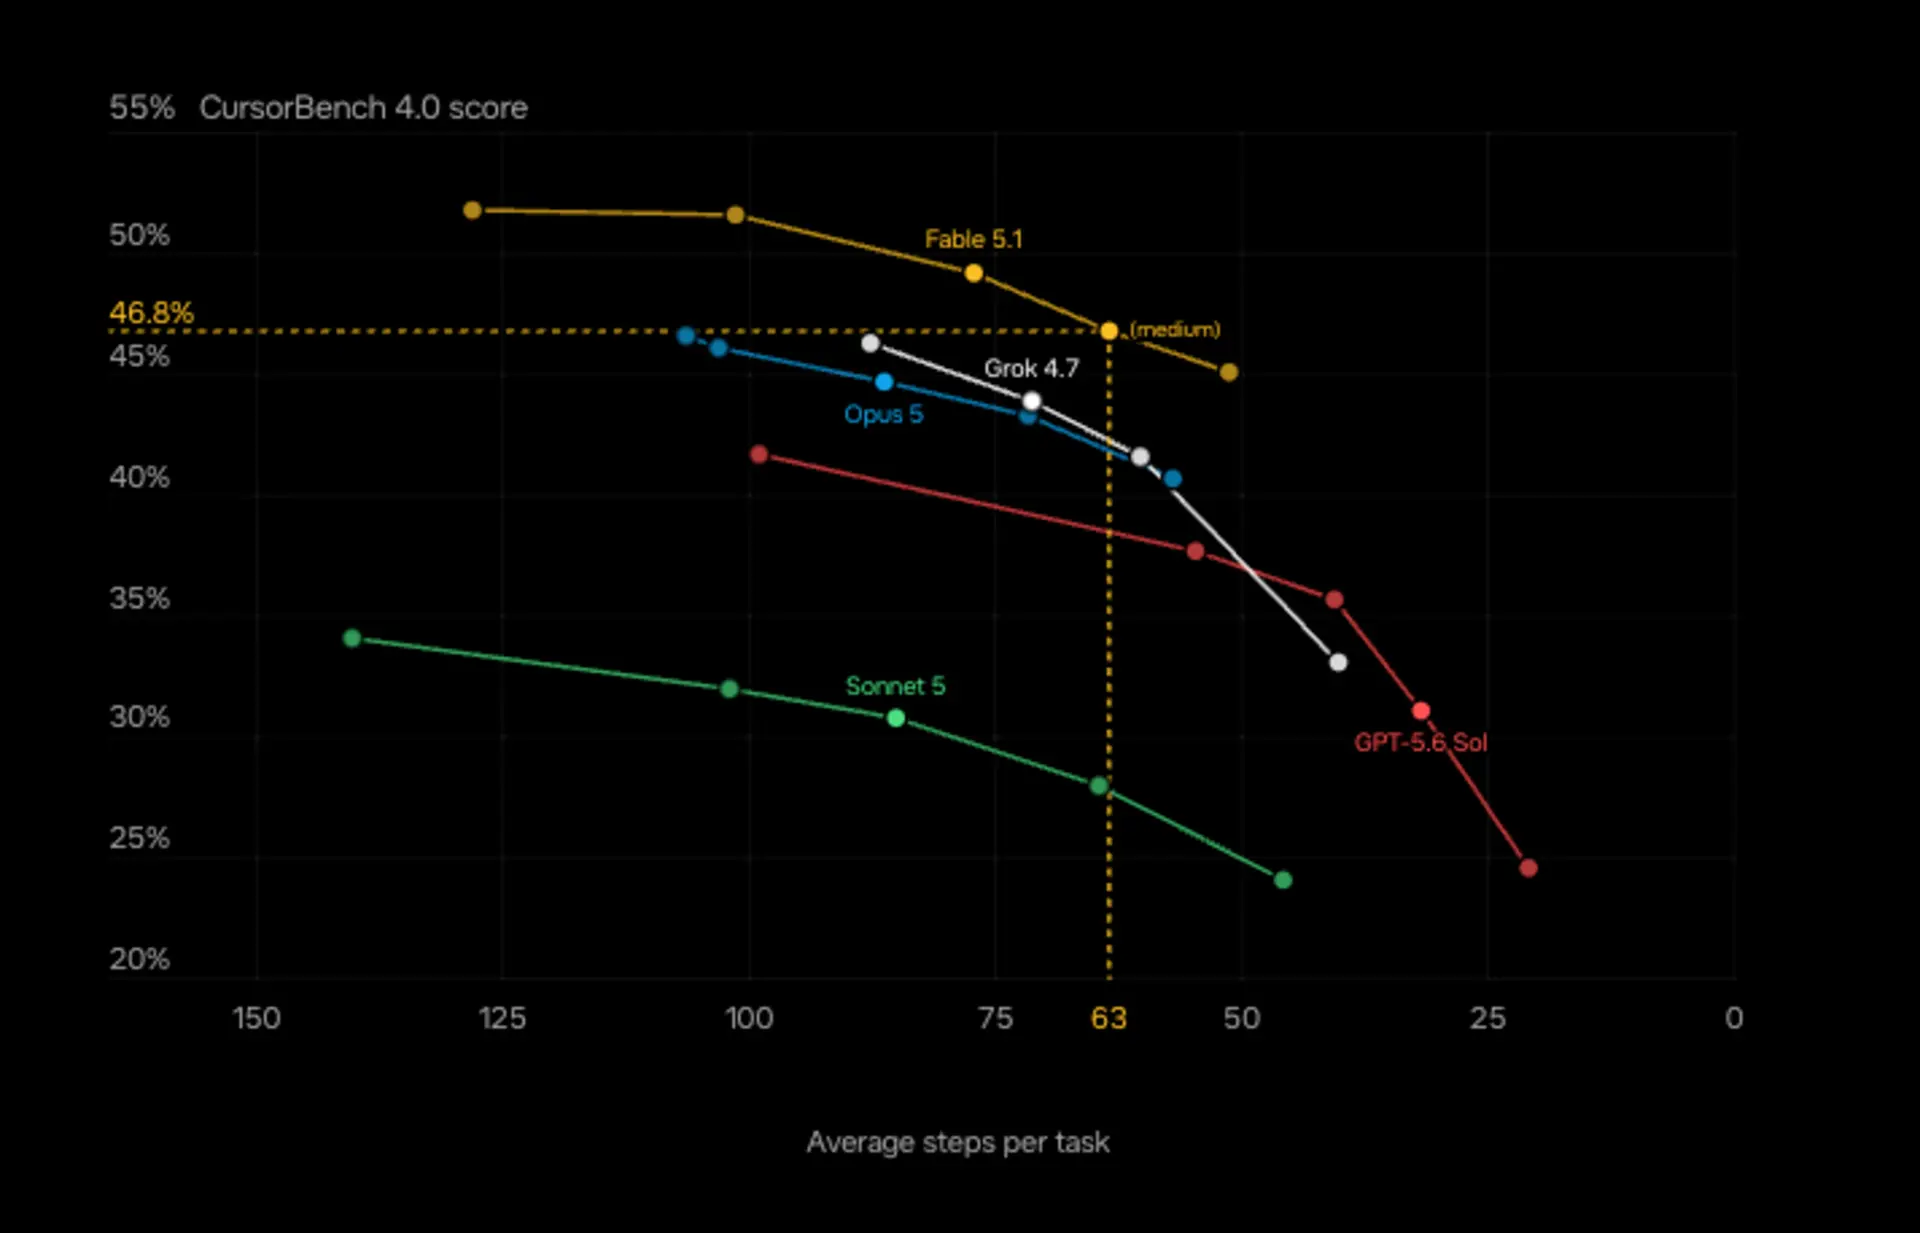
بهینهسازی مدیریت بافت متن و توانایی اعتبارسنجی مستقل، خطاهای شناختی خروجی را کاهش میدهد. در آزمون CursorBench 4.0 که بار پردازشی سنگینی روی وظایف کدنویسی بلندمدت ایجاد میکند، Grok 4.7 بهترین نسبت کارایی به هزینه را در کلاس خود به نمایش گذاشت.
سازگاری ذاتی با زیرساخت Grok Bot نیز در معماری گنجانده شده تا تعامل کلامی و پاسخگویی به درخواستهای عمومی با دقت بیشتری همراه شود. در زمینهی تولید اسناد فنی و ارائههای اداری، بنچمارکهای تخصصی نظیر GDPval و AA Briefcase که شبیهساز وظایف وکلا، تحلیلگران مالی و کادر درمان هستند، نشان میدهند عملکرد مدل پیشرفت محسوسی نسبت به Grok 4.6 داشته و نسخهی جدید در ردیف برترین مدلهای پیشرو قرار گرفته است.
ساختار امنیتی مدل از نو بازطراحی شده است تا در برابر حملات تزریق پرامپت و شکستن محدودیتها مقاومترین عملکرد ثبتشده را ارائه دهد. کنترل درخواستهای پرخطر در حوزههای زیستی و امنیت سایبری، دستاوردهای ملموسی به همراه داشته است. در بنچمارک ایمنی زیستی LatchBio، شاخص مهار درخواستهای پرخطر به ۶۲٫۴ درصد رسید.
دفاع سایبری بدون مسدودسازی ابزارهای مشروع پژوهشگران، یکی از چالشهای اصلی سیستمهای امنیتی بهشمار میرفت. در ارزیابی HackerBench v0.3 که میزان مقاومت در برابر سوءاستفادههای بدافزاری را میسنجد، تنها ۳٫۳ درصد از پرامپتهای مخاطرهآمیز از فیلترهای مدل عبور کردهاند، در حالی که پژوهشهای رسمی امنیت شبکه با کمترین نرخ رد بیهوده مواجه میشوند.
دسترسی مستقیم به مدل در محیطهای توسعهی Cursor و Grok Build فراهم شده و کاربران میتوانند از طریق رابط برنامهنویسی Grok API، پلتفرمهای ابری و مسیریابهای هوش مصنوعی به آن متصل شوند.
تعرفهی استفاده برای هر یک میلیون توکن ورودی ۲ دلار و برای هر یک میلیون توکن خروجی ۶ دلار تعیین شده است. برای پروژههای نیازمند پردازش سریع، نسخهی ویژهای با سرعت خروجی دوبرابر و قیمت معادل دو برابر نسخهی استاندارد نیز در دسترس قرار دارد.