گوگل از دو مدل هوش مصنوعی جدید Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking رونمایی کرد؛ مدلهایی که برای استدلال عمیق، گفتوگوی طبیعیتر و ساخت عاملهای صوتی قابلاتکا طراحی شدهاند.
بر اساس بیانیهی مطبوعاتی گوگل، هدف اصلی این نسخهها سادهتر کردن تعامل صوتی با هوش مصنوعی در اپلیکیشن جمنای و گوگل ورکاسپیس و موتور جستوجو است؛ بهطوری که مکالمه روانتر پیش برود، ابزارها در پسزمینه اجرا شوند و کاربر بتواند فقط با صدا، کارهای پیچیده را جلو ببرد.
دو مدل با دو مأموریت متفاوت
گوگل میگوید Gemini 3.8 Live برای مقیاسپذیری و هزینهی کارآمد ساخته شده و ترکیبی از هوش مکالمهای، گفتوگوی روان و درک دیداری را ارائه میکند. در مقابل، Gemini 3.8 Live Extended Thinking برای وظایف پیچیدهتر طراحی شده و روی استدلال چندمرحلهای و سطح بالاترِ هوش تمرکز دارد.
در لایهی محصول، هر دو مدل بهعنوان بلوکهای سازندهی عاملهای صوتی آمادهی تولید معرفی شدهاند؛ یعنی همان سامانههایی که باید هم پاسخگو باشند، هم پیوستگی مکالمه را حفظ کنند و هم بتوانند با ابزارها و API-ها کار کنند.
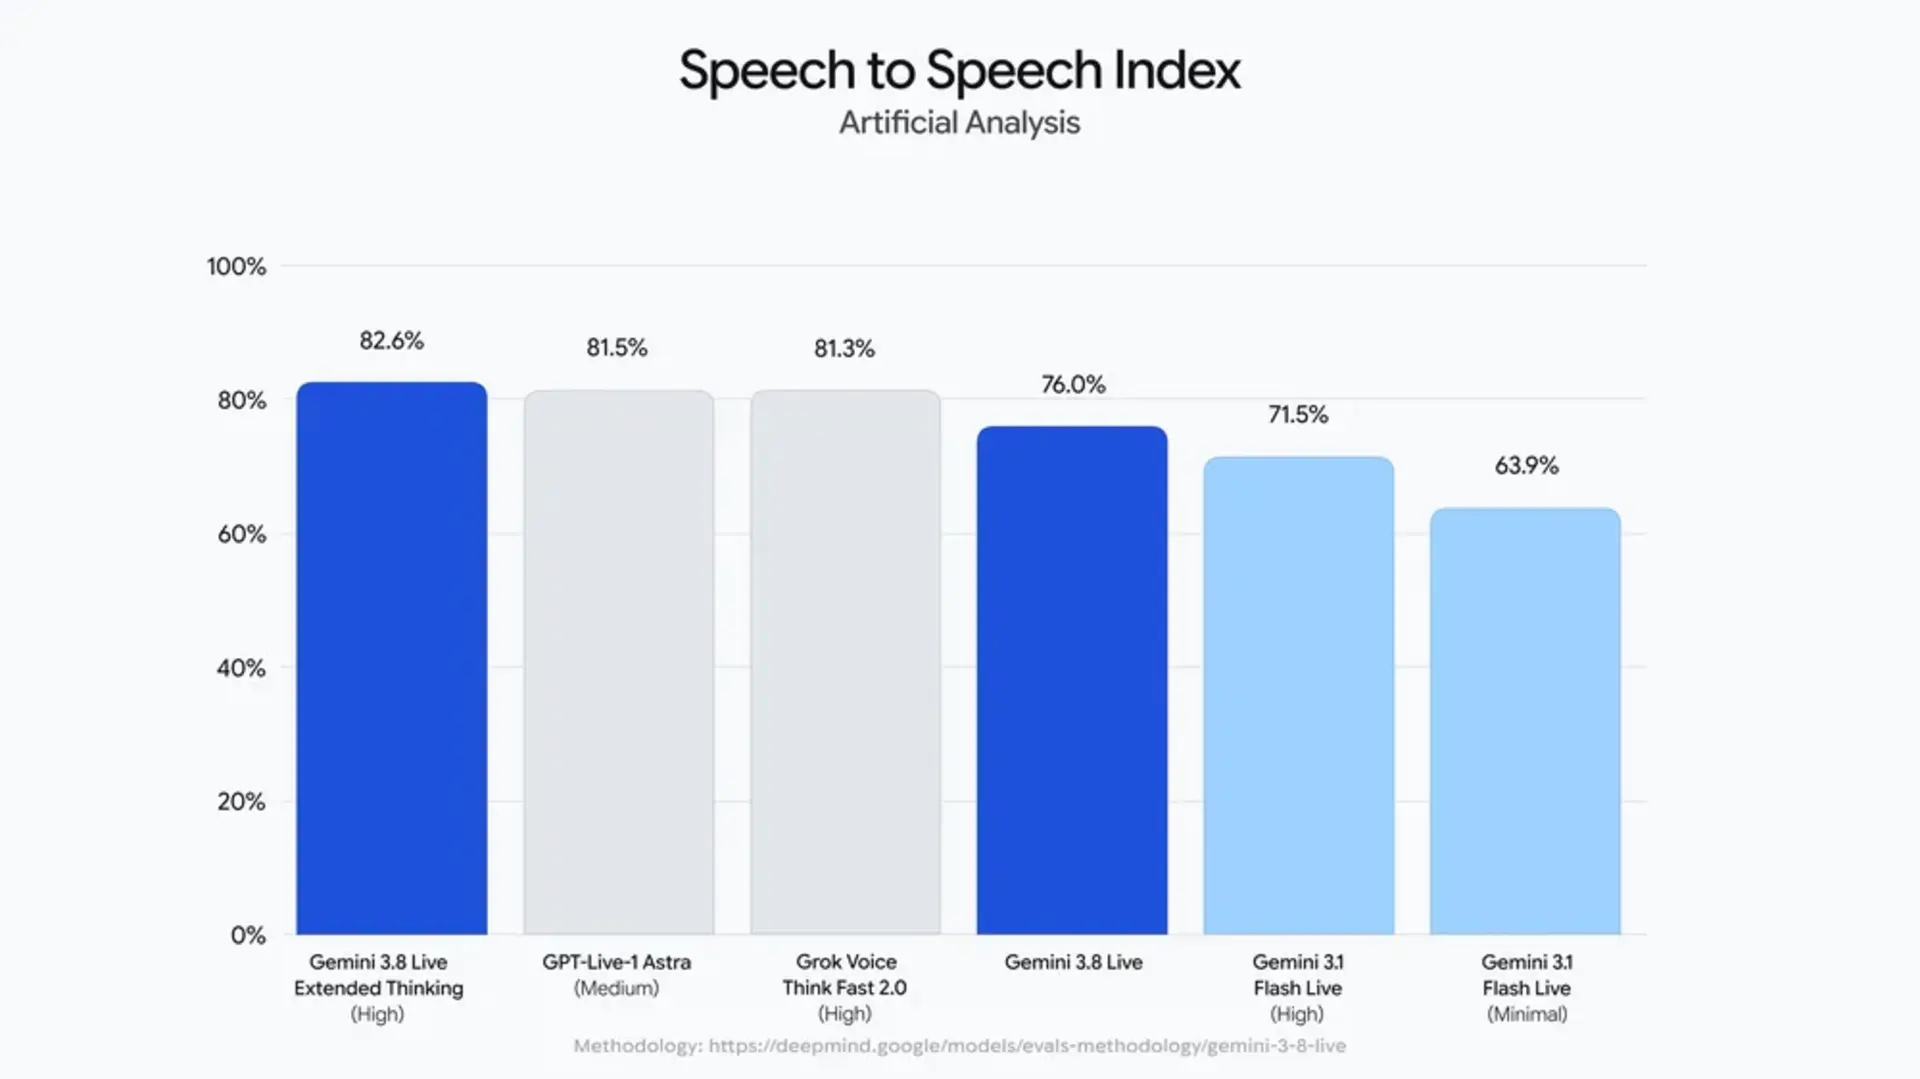
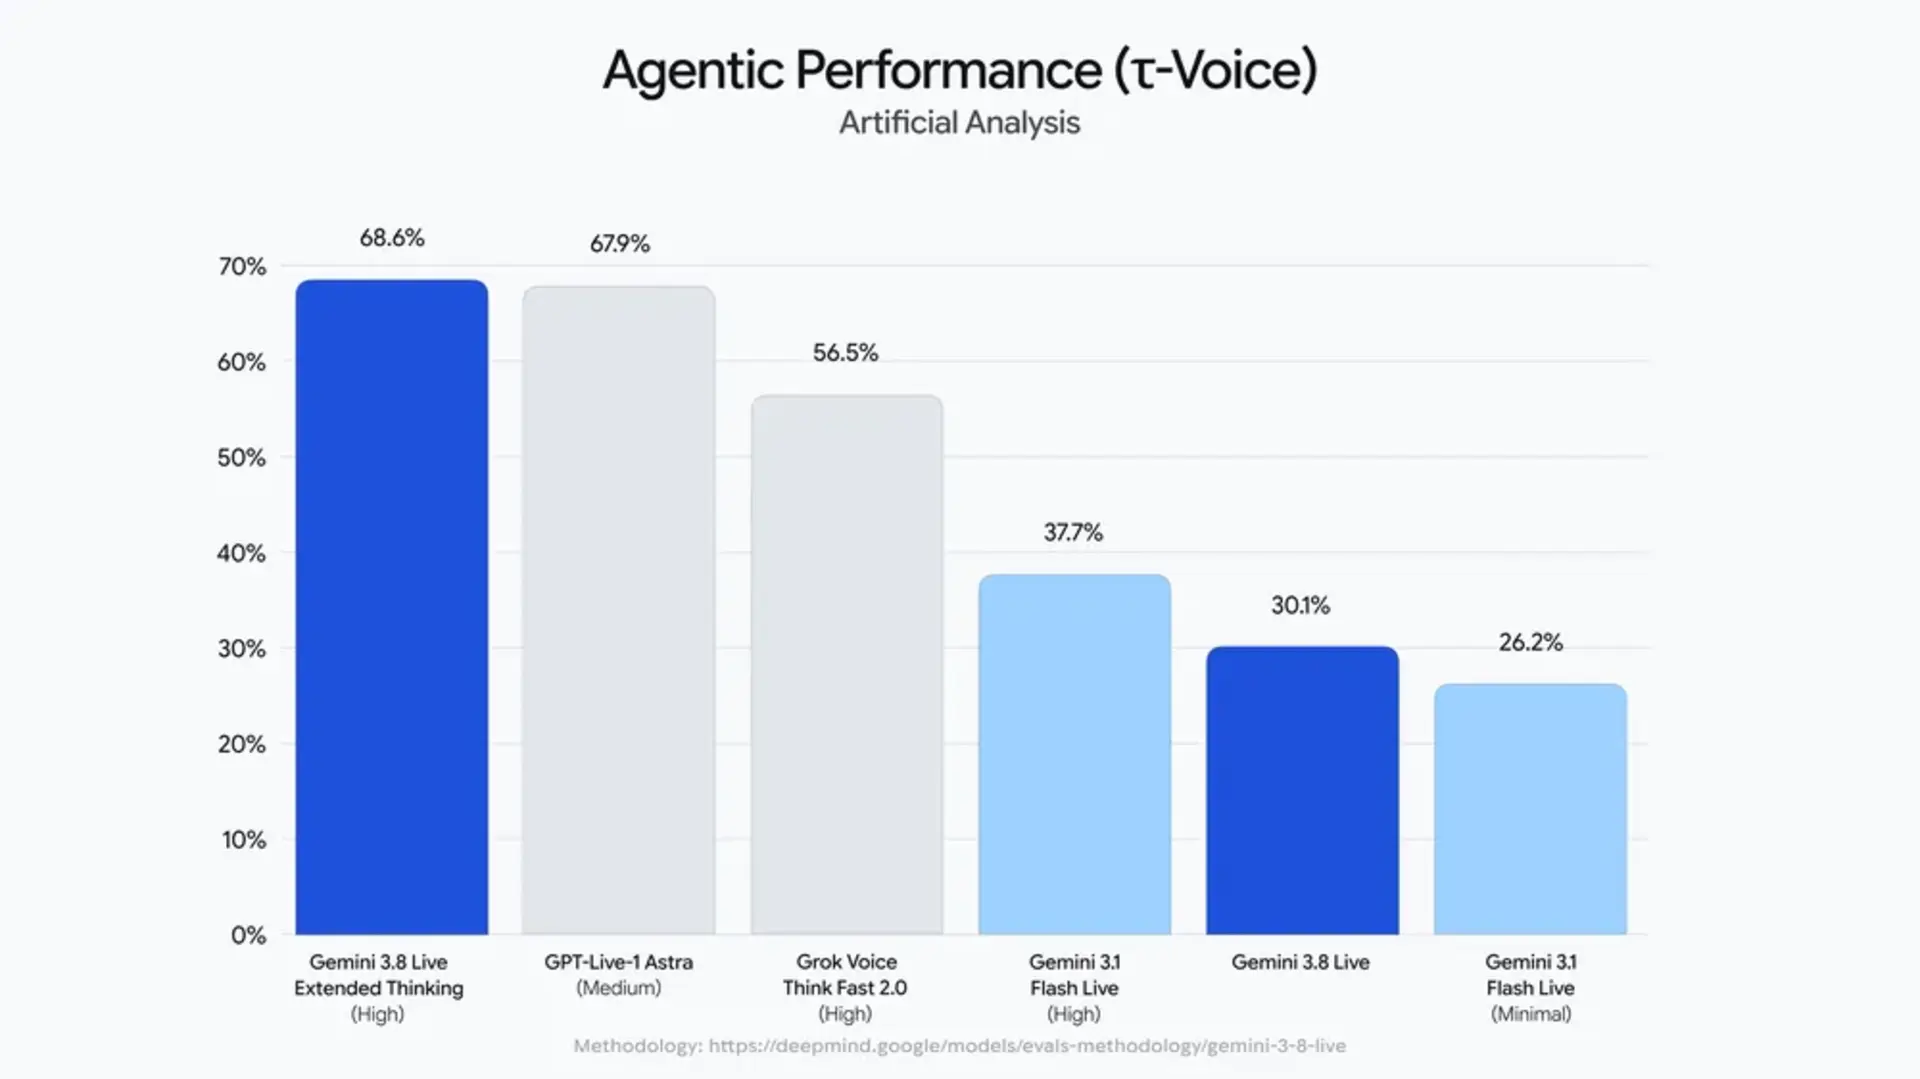
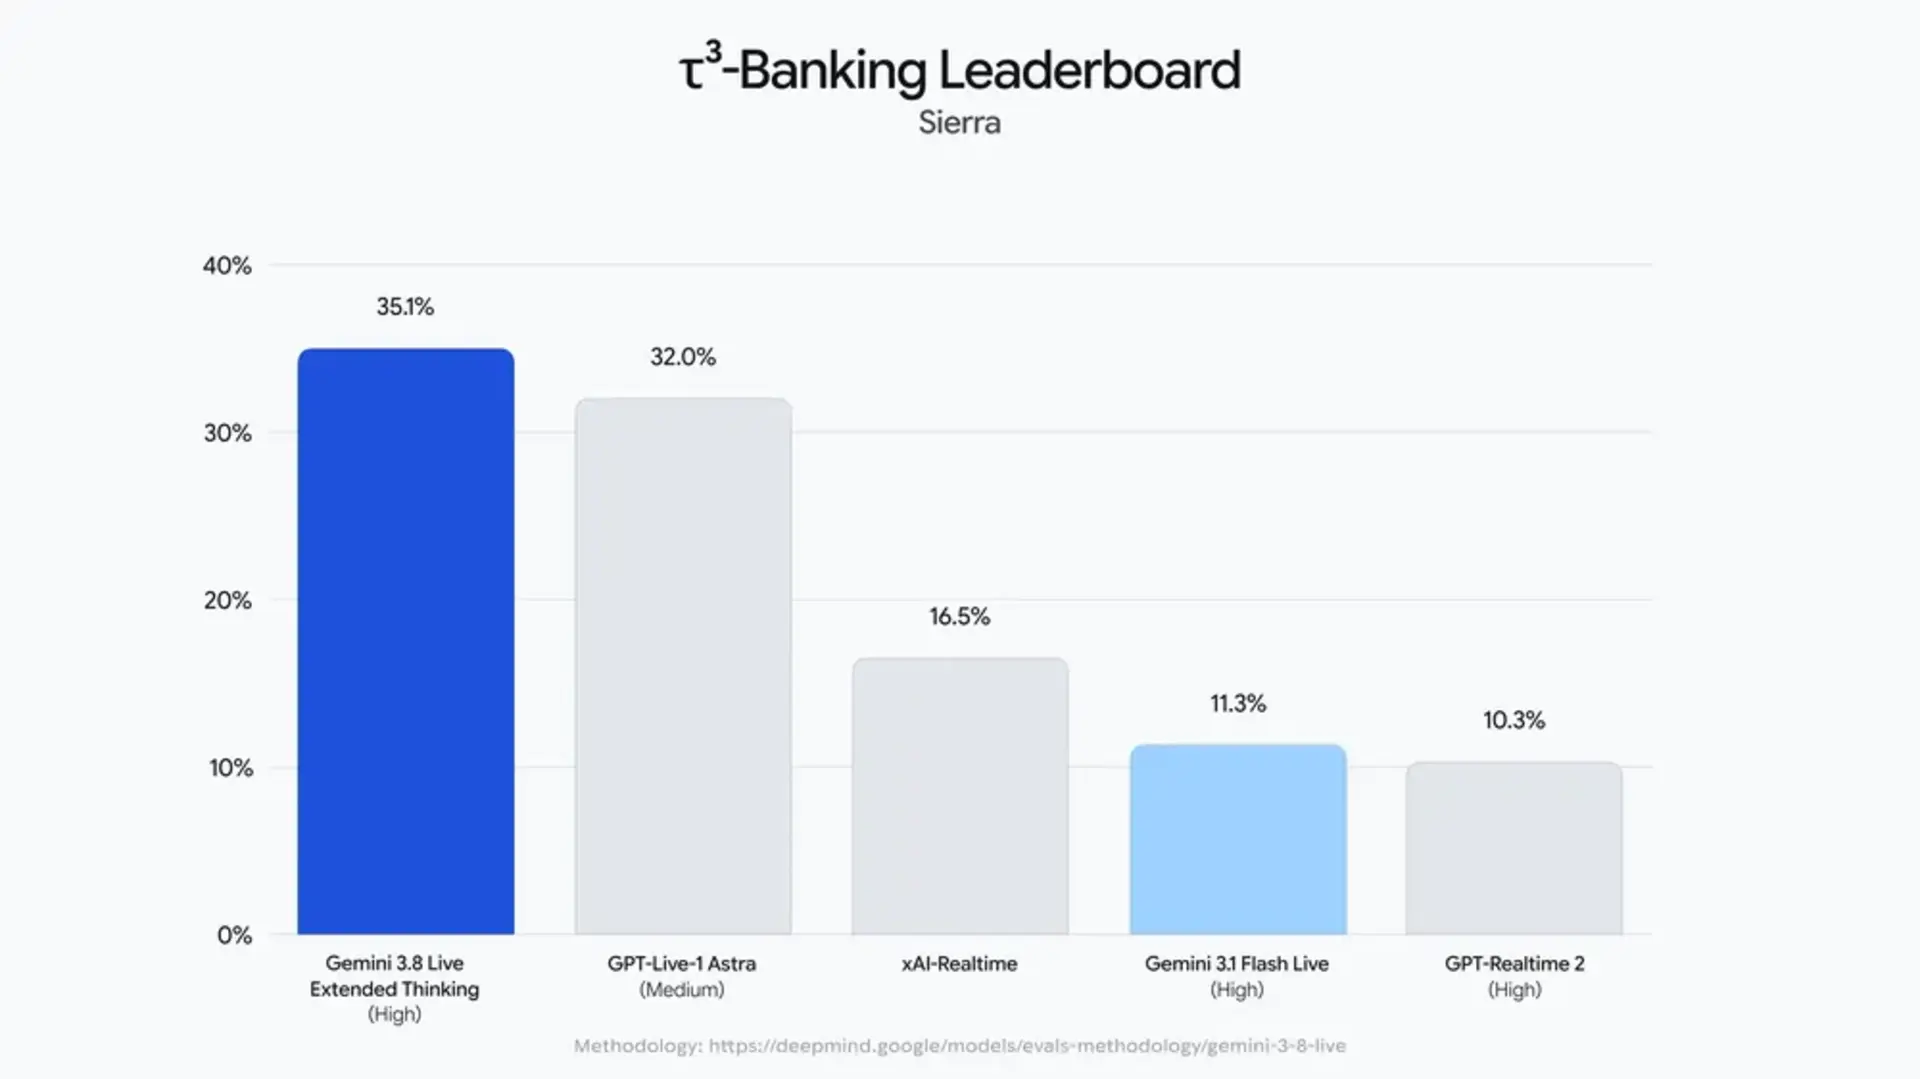
گوگل برای نسخهی Extended Thinking چند شاخص مهم منتشر کرده است. در Artificial Analysis Speech to Speech Quality Index، این مدل با امتیاز ۸۲٫۶ در رتبهی نخست قرار گرفته، در τ-Voice برای تکمیل وظایف عاملمحور، امتیاز ۶۸٫۶ درصد ثبت کرده و در Sierra's τ-Voice-banking به امتیاز ۳۵٫۱ درصد رسیده است.
پخش از رسانه
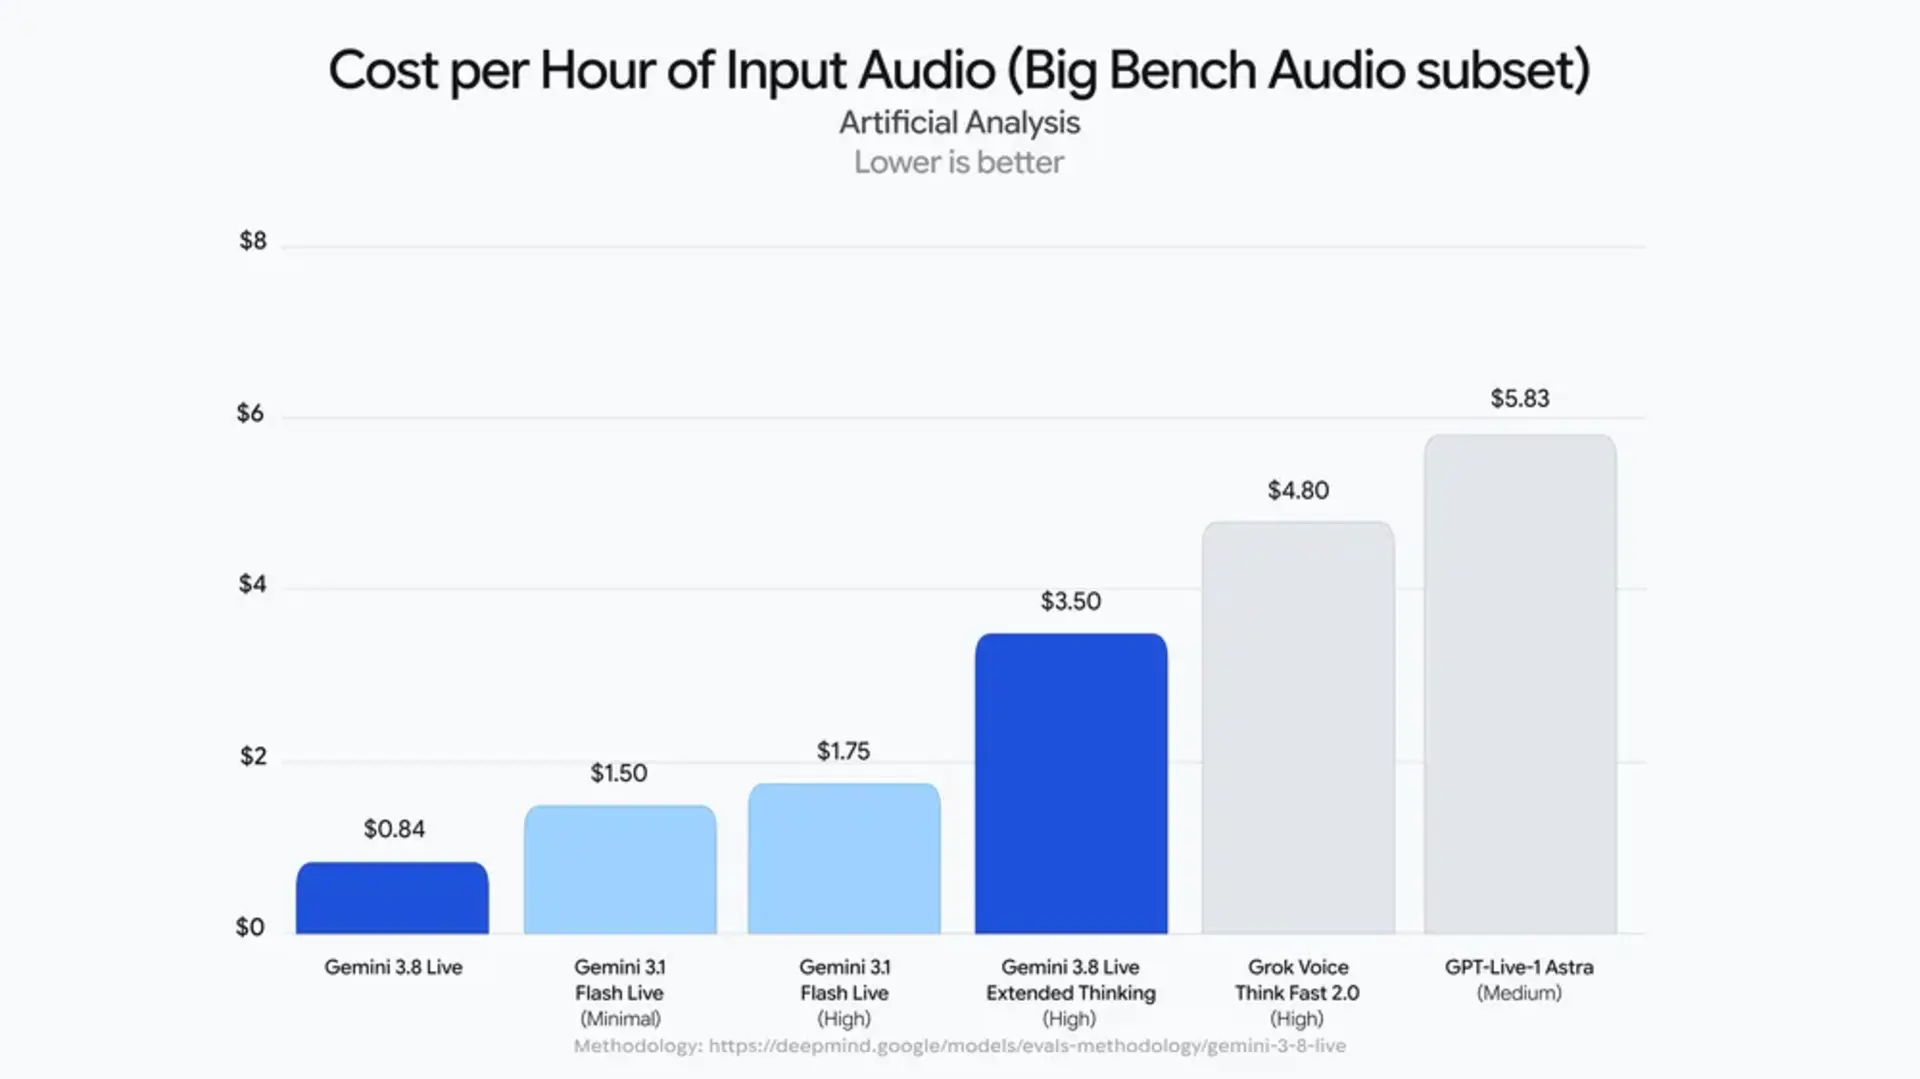
مدل جدید گوگل در Big Bench Audio امتیاز ۹۷٫۷ درصد را به دست آورده و گوگل تأکید میکند که همهی این نتایج در عین حفظ قیمت رقابتی نسبت به دیگر مدلهای مرزی ثبت شدهاند. در بنچمارک ServiceNow's EVA-Bench، مدلهای Live مرز کارآیی پارتو را برای گردشکارهای پیچیده جابهجا کردهاند؛ ترکیبی از دقت و کیفیت مکالمه که برای عاملهای سازمانی اهمیت زیادی دارد.
Gemini 3.8 Live ورودیهای بصری را تقریبا بهصورت آنی پردازش میکند و بافت بیشتری به مکالمه میافزاید. این مدل همچنین میتواند میان ۹۷ زبان پشتیبانیشده در میانهی گفتوگو بهطور خودکار جابهجا شود. اجرای ابزارها و فراخوانی API-ها نیز در پسزمینه انجام میشود، در حالی که مکالمه ادامه دارد.
در نسخهی Extended Thinking، مدل همزمان میاندیشد و صحبت میکند. گوگل میگوید این نسخه از نشانههای کلامی اولیه مانند «وایسا بررسی کنم» برای تأیید طبیعی درخواست کاربر استفاده میکند و سپس با روایت زندهی پیشرفت کار، او را در جریان مراحل چندگانه نگه میدارد. حاصل کار، تجربهای است که قرار است برای گردشکارهای پیچیده، از ریتم گفتوگو نکاهد.
گوگل میگوید همهی صداهای تولیدشده با محصولات هوش مصنوعی این شرکت با SynthID نشانهگذاری میشوند. این نشان نامحسوس مستقیما در خروجی صوتی تنیده میشود تا محتوای تولیدشده با هوش مصنوعی قابل شناسایی بماند و خطر انتشار اطلاعات نادرست کاهش یابد.
پخش از رسانه
هوش مصنوعی Gemini 3.8 Live از امروز منتشر میشود و برای توسعهدهندگان، دسترسی از طریق Gemini API و Google AI Studio فراهم شده است. برای سازمانها، نسخهی خصوصی پیشنمایش در Gemini Enterprise فعال شده و بهزودی به Gemini Enterprise for Customer Experience میرسد. برای کاربران عمومی، دسترسی در Search Live آغاز شده است.
به گفتهی گوگل، Gemini 3.8 Live Extended Thinking هم از امروز منتشر میشود. برای توسعهدهندگان، همان مسیر Gemini API و Google AI Studio فعال است. برای سازمانها، پیشنمایش خصوصی در Gemini Enterprise در دسترس قرار گرفته و بهزودی به Gemini Enterprise for Customer Experience و مشتریان تجاری Google Workspace میرسد. برای کاربران، این مدل در Gemini Live و برای مشترکان Google AI Pro و Ultra در Workspace منتشر میشود.
نظر شما دربارهی نسل تازهی مدلهای صوتی گوگل چیست؟