در دنیای سختافزار و لپتاپهای ویندوزی، همواره یک قانون نانوشته وجود دارد: «قدرت بیشتر، مساوی است با مرگ زودرس باتری». سالها عادت کرده بودیم که پردازندههای سری H اینتل را به عنوان قاتلان بیرحم باتری بشناسیم و برای داشتن یک لپتاپ با شارژدهی مناسب، ناچاراً به پردازندههای ضعیفتر سری U پناه ببریم. اما کالبدشکافی معماری خانوادهی Core Ultra Series 3 یا همان Panther Lake نشان میدهد که اینتل سرانجام شکاف میان عملکرد بالا و بهرهوری انرژی را تا حد زیادی کاهش داده است.
با نگاهی دقیق به اسلایدهای رسمی معرفی این خانواده، متوجه یک تغییر استراتژی بیسابقه در رویکرد بازاریابی تیم آبی میشویم؛ اینتل در اقدامی ساختارشکنانه، بهجای اینکه پرچمدار جدیدش را صرفاً از نظر «قدرت خام پردازشی» به رخ بکشد، پردازندهی قدرتمند Core Ultra 9 388H را در نمودار «عملکرد به ازای توان مصرفی»، مستقیماً رودروی پردازندههای اقتصادی و کممصرف نسلهای گذشته (مانند Meteor Lake 150U و Arrow Lake 265U) قرار داده است! با این مقایسهی نامتعارف، اینتل میخواهد نشان دهد که دیگر فقط به دنبال رکوردشکنی در قدرت پردازشی و افزایش نرخ فریم نیست؛ بلکه پرچمدار همهفنحریف جدیدش حالا حتی در مقایسه با پردازندههای کممصرف نسلهای گذشته نیز میتواند در برخی آزمونها به ازای عملکرد یکسان، انرژی کمتری مصرف کند.
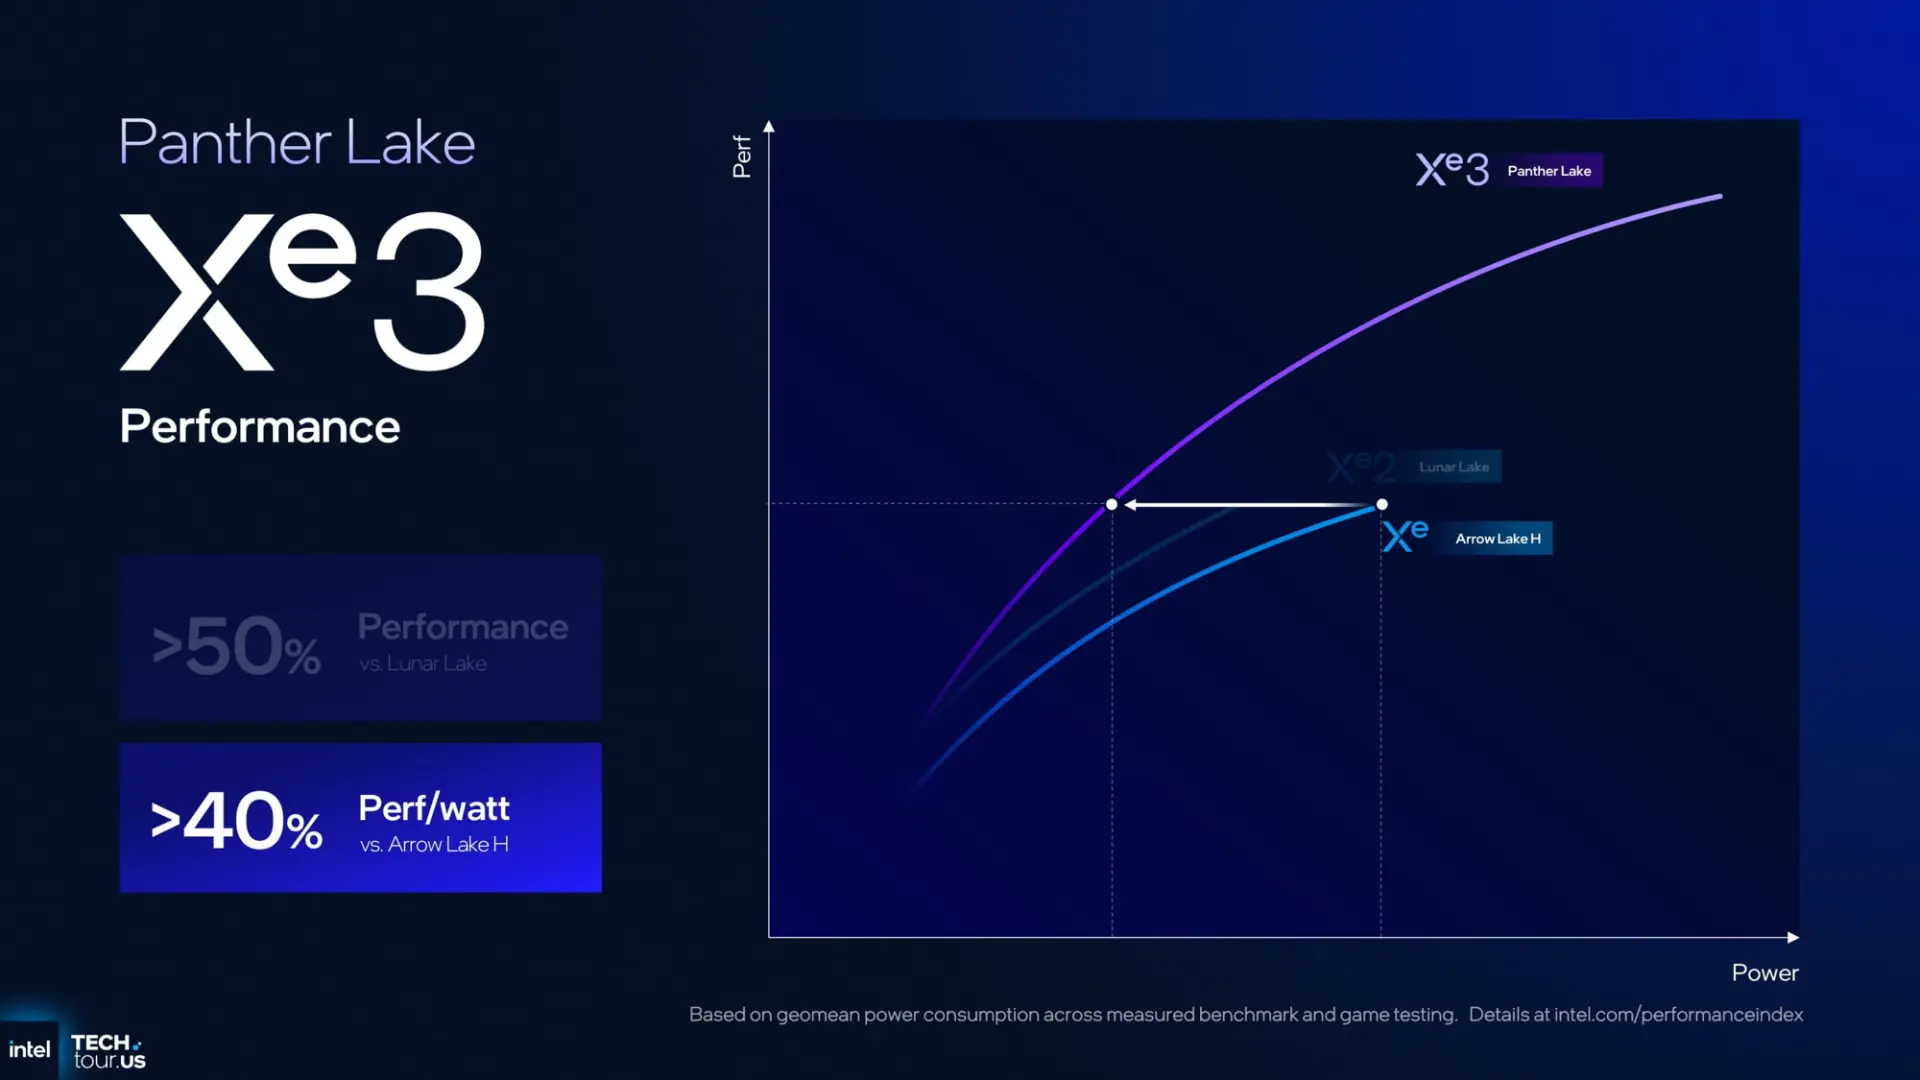
البته ریشهی این مقایسهی جسورانه و تمرکز ویژهی اینتل بر کاهش مصرف انرژی را باید در فشار سنگین رقبا هم جستوجو کرد. تا همین اواخر بود که کفهی ترازوی «کارایی بهازای هر وات» بهوضوح بهنفع معماری ARM سنگینی میکرد. اما اینتل با پنترلیک نشان داد مشکل نه در ذات معماری x86، بلکه در شیوهی پیادهسازی آن بوده است. این نسل با ارائه جهش چشمگیر ۳۰ تا ۴۰ درصدی در بهرهوری انرژی نسبت به نسل قبل، دیگر صرفاً تلاشی برای «بهبود بازدهی» نیست، بلکه رقیبی قدرتمند است که مستقیماً به مصاف تراشهی کممصرف اپل میرود.
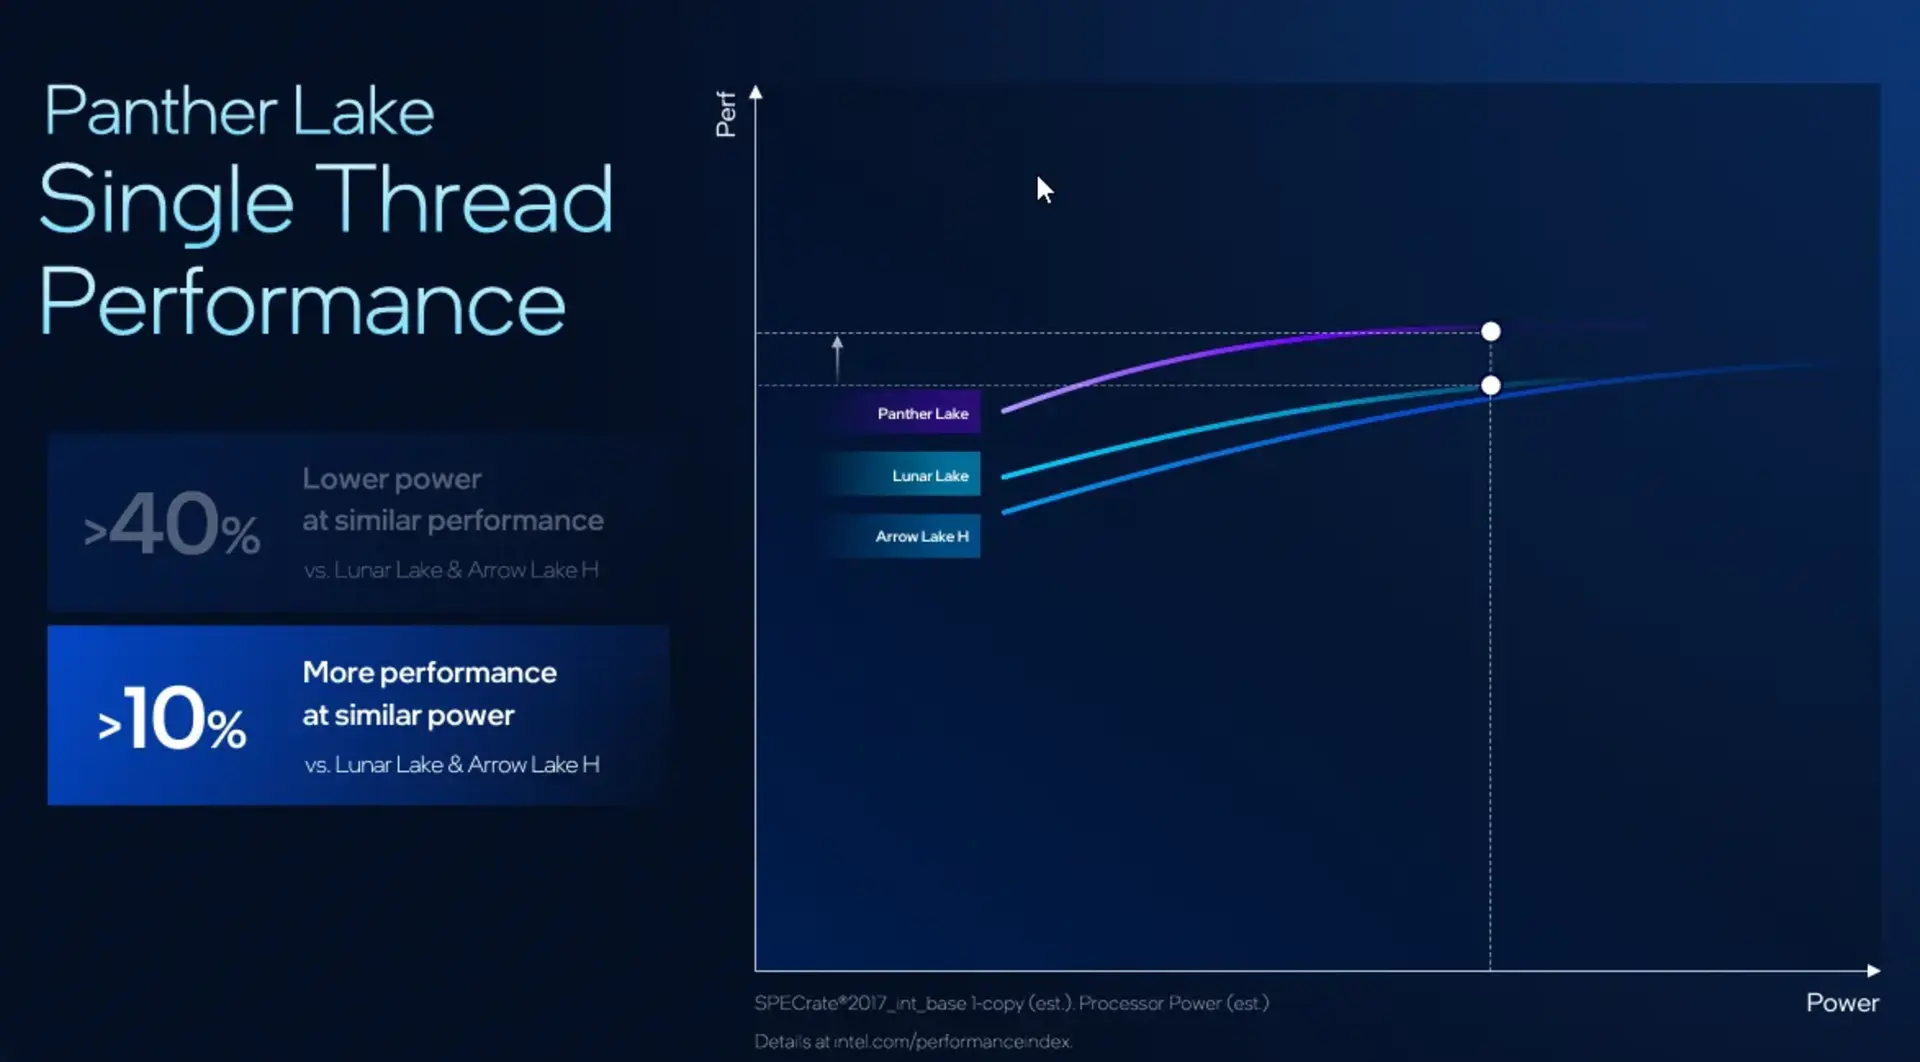
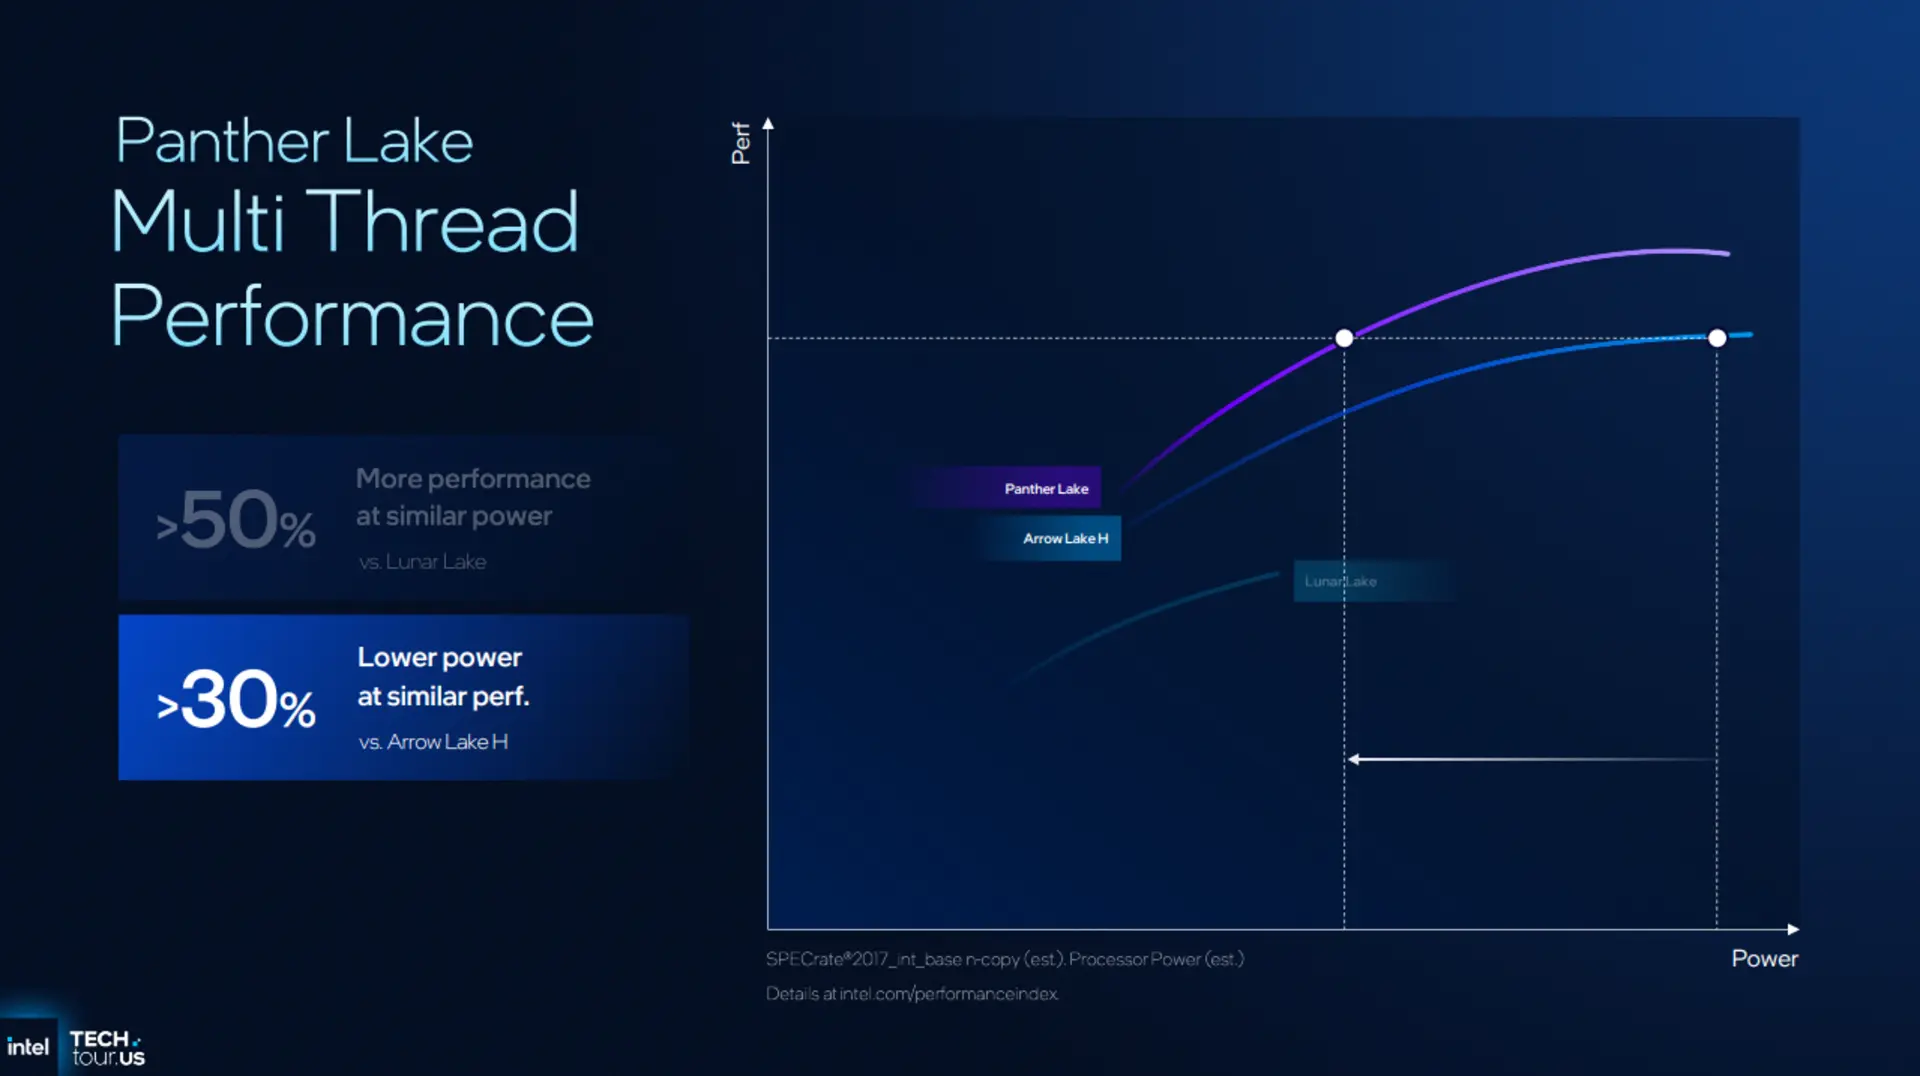
اینتل با پنترلیک مدعی است که توانسته شکاف تاریخی راندمان را پر کند و در همان سطح از مصرف انرژی، پردازشهای سنگین چندرشتهای و هوش مصنوعی قدرتمندی را در اکوسیستم ویندوز ارائه دهد. پنترلیک را میتوان نقطهی تلاقی تجربهی اینتل در طراحی تراشههای کممصرف Lunar Lake و معماری قدرتمند Arrow Lake دانست؛ محصولی که تلاش میکند دستاوردهای هر دو مسیر را در قالب یک معماری یکپارچه به کار بگیرد.
اما سؤال اصلی اینجاست: چطور ممکن است یک تراشهی مبتنیبر x86، همزمان در بالاترین سطح بهرهوری انرژی باشد و در عین حال در پردازشهای سنگین مرزها را جابهجا کند؟ برای پاسخ به این سؤال، در ادامهی این مقاله نگاه جامعی خواهیم انداخت به نسل سوم پردازندههای Core Ultra و نوآوریهایی که این جهش تاریخی را رقم زدهاند.
کالبدشکافی پردازندههای پنترلیک؛ لگوی سیلیکونی اینتل
سالهاست که دنیای پردازندهها با پارادایم «طراحی یکپارچه» (Monolithic) شناخته میشود؛ ساختاری که در آن تمام اجزای حیاتی، از واحدهای محاسباتی تا واحد گرافیکی و کنترلرهای ورودی و خروجی، همگی روی یک قالب سیلیکونی واحد بودند. اگرچه چنین ساختاری، مزیت «تأخیر ناچیز» را به همراه داشت، اما با کاهش ابعاد تراشهها و پیچیدگی سرسامآور تراشهها، این رویکرد به بنبست بازدهی و هزینههای گزاف تولید رسید. حالا دوران، دوران «چیپلتها» (Chiplets) یا به قول اینتل «تایلها» (Tiles) است؛ رویکردی شبیه به خانهسازی با لگو که در آن قطعات، به صورت مجزا تولید شده و سپس با رابطهای فوقسریع در کنار هم یک پردازندهی واحد را تشکیل میدهند. چنین ساختار ماژولاری، به کمپانی سازنده اجازه میدهد هر بخش را متناسب با نیازهای عملکردی و مصرف انرژیاش طراحی و تولید کند یعنی واحدهای محاسباتی که از نظر کارایی بیشترین حساسیت را دارند، میتوانند با پیشرفتهترین فناوریهای ساخت تولید شوند، در حالیکه سایر بخشها با فناوری ساخت ارزانتری توسعه یابند.
بههمیندلیل اینتل، از نسل پردازندههای Meteor Lake بهسوی استراتژی «تفکیکسازی» (Disaggregation) روی آورد. مسیری که در Lunar Lake و Arrow Lake ادامه یافت اما تا بلوغ کامل فاصلهی زیادی داشت؛ اکنون سری پردازندههای Panther Lake را میتوان نقطهای دانست که این استراتژی برای نخستینبار به شکلی منسجم، پخته و کامل پیادهسازی شده و این سری از پردازندههای اینتل از ساختار تمامچیپلتی استفاده میکنند.
در راستای چنین ساختاری، پنترلیک از تایل محاسباتی (Compute Tile)، تایل گرافیکی (GPU Tile) و تایل کنترلر پلتفرم (Platform Controller Tile) تشکیل شده که همگی با قرارگیری روی یک میانلایهی سیلیکونی فعال با فناوری بستهبندی Foveros 2.5D بهیکدیگر متصل شدهاند. تایل محاسباتی در پردازندههای پنترلیک با فناوری ساخت Intel 18A، یکی از پیشرفتهترین نودهای اختصاصی اینتل تا به امروز ساخته شده و شامل هستههای CPU، واحد پردازش عصبی (NPU) و موتور مدیا (Media Engines) و کش سمت حافظه (Memory Side Cache) میشود.
تایل گرافیکی پنترلیک نیز با بهرهگیری از معماری جدید Xe3 و ساخته شده با فناوری ساخت ۳ نانومتری شرکت تیاسامسی (TSMC N3P)، تا ۱۲ هستهی گرافیکی Xe و واحدهای اختصاصی رهگیری پرتو (Ray Tracing) را در خود میزبانی میکند. یکی از مزایای کلیدی تفکیک تایلهای محاسباتی و گرافیکی، افزایش استقلال عملیاتی آنهاست. این ساختار به هر تایل اجازه میدهد تا متناسب با نوع بار کاری، بهصورت مستقلتری مدیریت شود و در محدودهی ولتاژ، توان و دمای مناسب خود فعالیت کند. اگرچه تایلها همچنان از نظر حرارتی و توان مصرفی با یکدیگر در ارتباط هستند، این جداسازی امکان مدیریت مستقلتر توان و دمای هر بخش از تراشه را فراهم میکند.
از سوی دیگر، تمام وظایف ارتباطی و درگاههای ورودی و خروجی به «تایل کنترلر پلتفرم» واگذار شده که با مدیریت همه جانبهی قابلیتهایی نظیر Thunderbolt، استانداردهای ارتباطی Wi-Fi 7 و Bluetooth 6 و همچنین مسیرهای PCIe، نقش هستهی مرکزی ارتباطات را ایفا میکند.
پشت پرده بهرهوری چشمگیر پنترلیک
با وجود تمام مزایای ساختار ماژولار و لگوی سیلیکونی، صرف تفکیک کردن اجزای پردازنده بهتنهایی نمیتواند جهش خیرهکنندهی ۴۰ درصدی در بهرهوری انرژی را توجیه کند. راز اصلی این بهرهوری را باید در دل تایل محاسباتی و در ابعاد اتمی جستوجو کرد؛ جایی که فناوری ساخت Intel 18A وارد میدان میشود؛ نام 18A به مقیاس ۱۸ آنگستروم اشاره دارد و با اینکه نباید آن را بهعنوان اندازهی واقعی ترانزیستور در نظر گرفت، اما در آن ترانزیستورها و مسیرهای سیمکشی فشردهتر و کوچکتر از هر زمان دیگری شدهاند. روی کاغذ، کوچک شدن این ساختارها یک بازی برد-برد است؛ چرا که با کاهش ظرفیت خازنی، انرژی مورد نیاز برای هر بار خاموش و روشن شدن ترانزیستور (سوئیچینگ) کمتر میشود و میتوان به عملکردی بالاتر در همان محدودهی توان و گرما دست یافت.
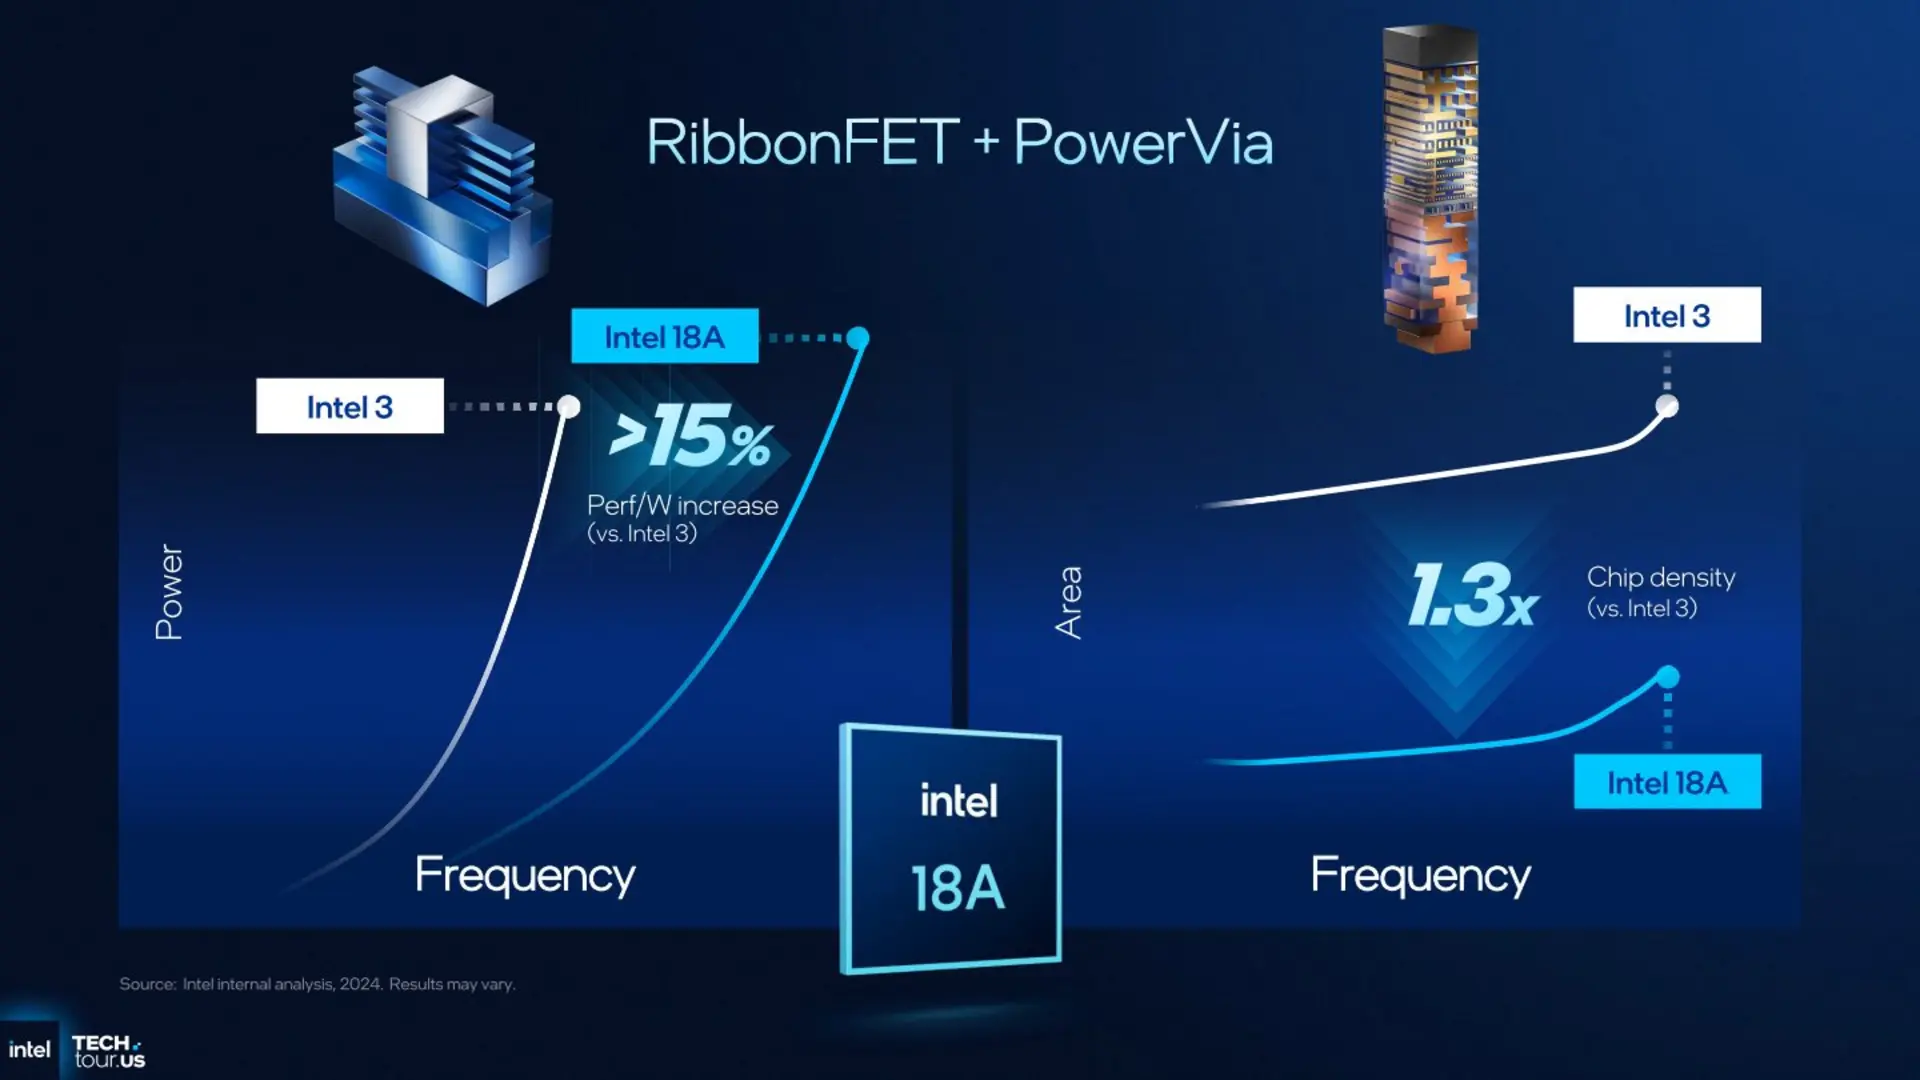
اما در این سطح از ابعاد میکروسکوپی، با نزدیک شدن به محدودیتهای فیزیکی سیلیکون و بروز خاصیت موجگونهی الکترونها، این «صرفا کوچکسازی» منجر به نشت جریان و هدررفت شدید انرژی میشود؛ جایی که الکترونها از میان دیوارههای نازک اتمی فرار میکنند و دما و مصرف انرژی تراشه را به شدت بالا میبرند.
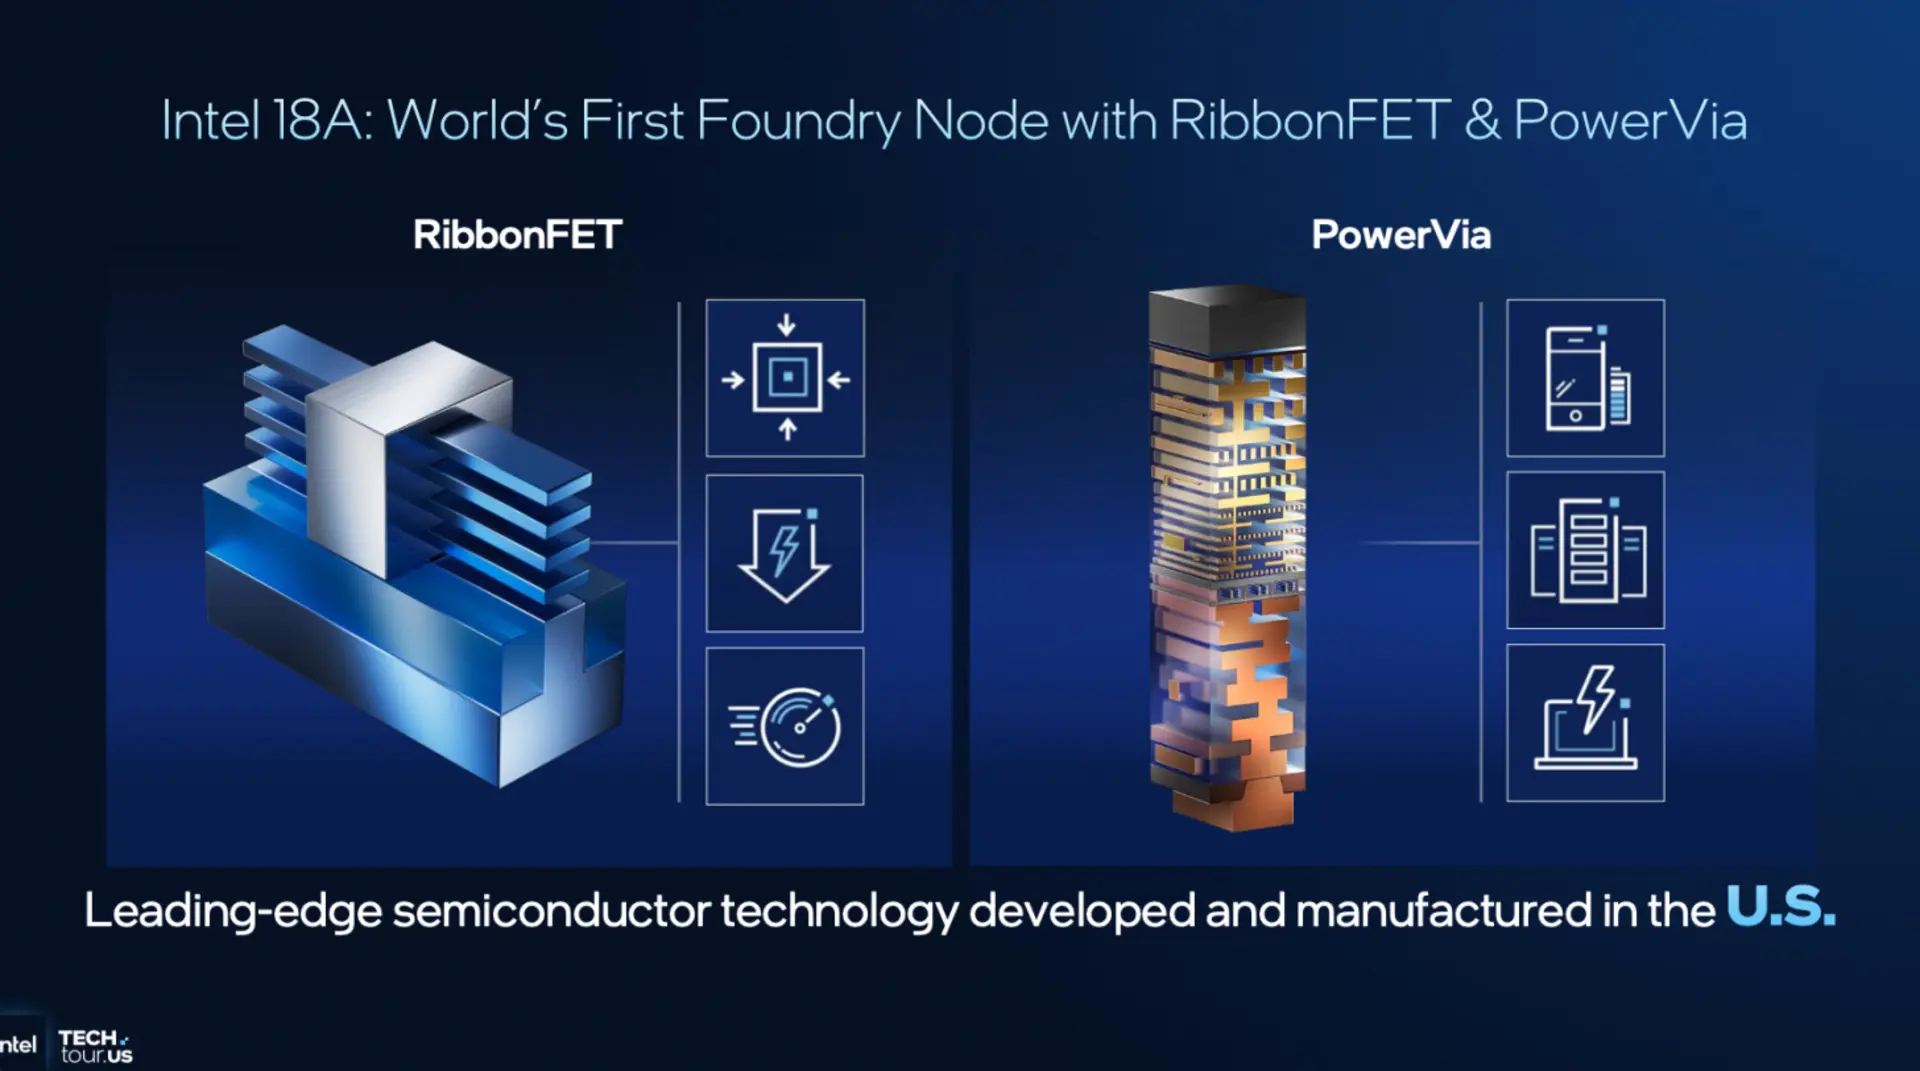
به همین دلیل اینتل با عبور از ترانزیستورهای FinFET به RibbonFET این مشکل را برطرف کرده است؛ در این معماری ساخت ترانزیستور، کانال بهطور کامل توسط گیت احاطه میشود تا روی حرکت الکترونها کنترل بیشتری داشته باشد و از نشت جریان جلوگیری کند.
اما تلاشهای اینتل برای بهینگی مصرف انرژی بههمینجا ختم نمیشود و تغییر بزرگ دیگر جداسازی مسیر برق از مسیر داده با فناوری PowerVia است که چالش برقرسانی را در این ابعاد فوقکوچک حل میکند؛ در حالیکه در تراشههای معمول، سیمکشیهای برق و داده در لایههای رویی در هم تنیده بودند و باعث اتلاف انرژی میشدند، اینتل در پنتر لیک شبکه توزیع برق را به پشت تراشه منتقل کرده است.
این جداسازی هوشمندانه با کوتاهتر کردن مسیر رسیدن انرژی به ترانزیستور و کاهش مقاومت الکتریکی، ولتاژ را با ثبات بسیار بالاتری مدیریت میکند؛ نتیجهی این مهندسی، خود را مستقیماً در بهبود شارژدهی باتری و حفظ پایداری عملکرد در پردازشهای سنگین در لپتاپ با پردازندههای سری سوم کور اولترا نشان میدهد.
زمانیکه صحبت از تفکیک اجزای پردازنده و ساختار ماژولار به میان میآید، یکی از چالشهای مهم که میتواند تمام دستاوردهای مصرف انرژی را بر باد دهد، احتمال ایجاد «گلوگاه ارتباطی» و هدررفت توان برای جابهجایی داده در میان تایلهای مختلف است. اینتل برای عبور از این چالش در پنترلیک، از نسل پیشرفتهی فناوری (Foveros) بهره میبرد. در این شیوه، تایلهای مختلف روی یک تایل پایه قرار میگیرند؛ اما یکی از عوامل مهم در تبادل سریع داده میان آنها، به نقاط اتصال بسیار ریز موسوم به میکروبامپ (Microbump) بازمیگردد.
میکروبامپها در واقع گویهای فلزی فوقالعاده ریزی هستند که بهعنوان پلهای الکتریکی میان چیپلتها و لایهی زیرین عمل میکنند. در فرآیند ساخت و در مرحلهی بستهبندی نهایی، این گویهای فلزی تحت فشار و حرارت، اتصالی بسیار کوتاه و مستقیم ایجاد میکنند که برخلاف روشهای سنتی، مسیر حرکت سیگنال را به حداقل میرساند. همین کوتاهی مسیر باعث میشود تایلها بتوانند با پهنای باند بسیار بالا و تأخیر ناچیز با یکدیگر تعامل کنند و سیستمعامل با پردازنده بهعنوان یک پلتفرم واحد کار میکند.
تایل محاسباتی
بلوک محاسباتی Panther Lake بسته به مدل، حداکثر تا ۱۶ هستهی پردازشی را در دل خود جای میدهد که شامل چهار هستهی جدید و قدرتمند (P-Core) از معماری Cougar Cove، هشت هستهی کممصرف (E-Core) و چهار هستهی فوقکممصرف (LP-E) از معماری Darkmont میشود.
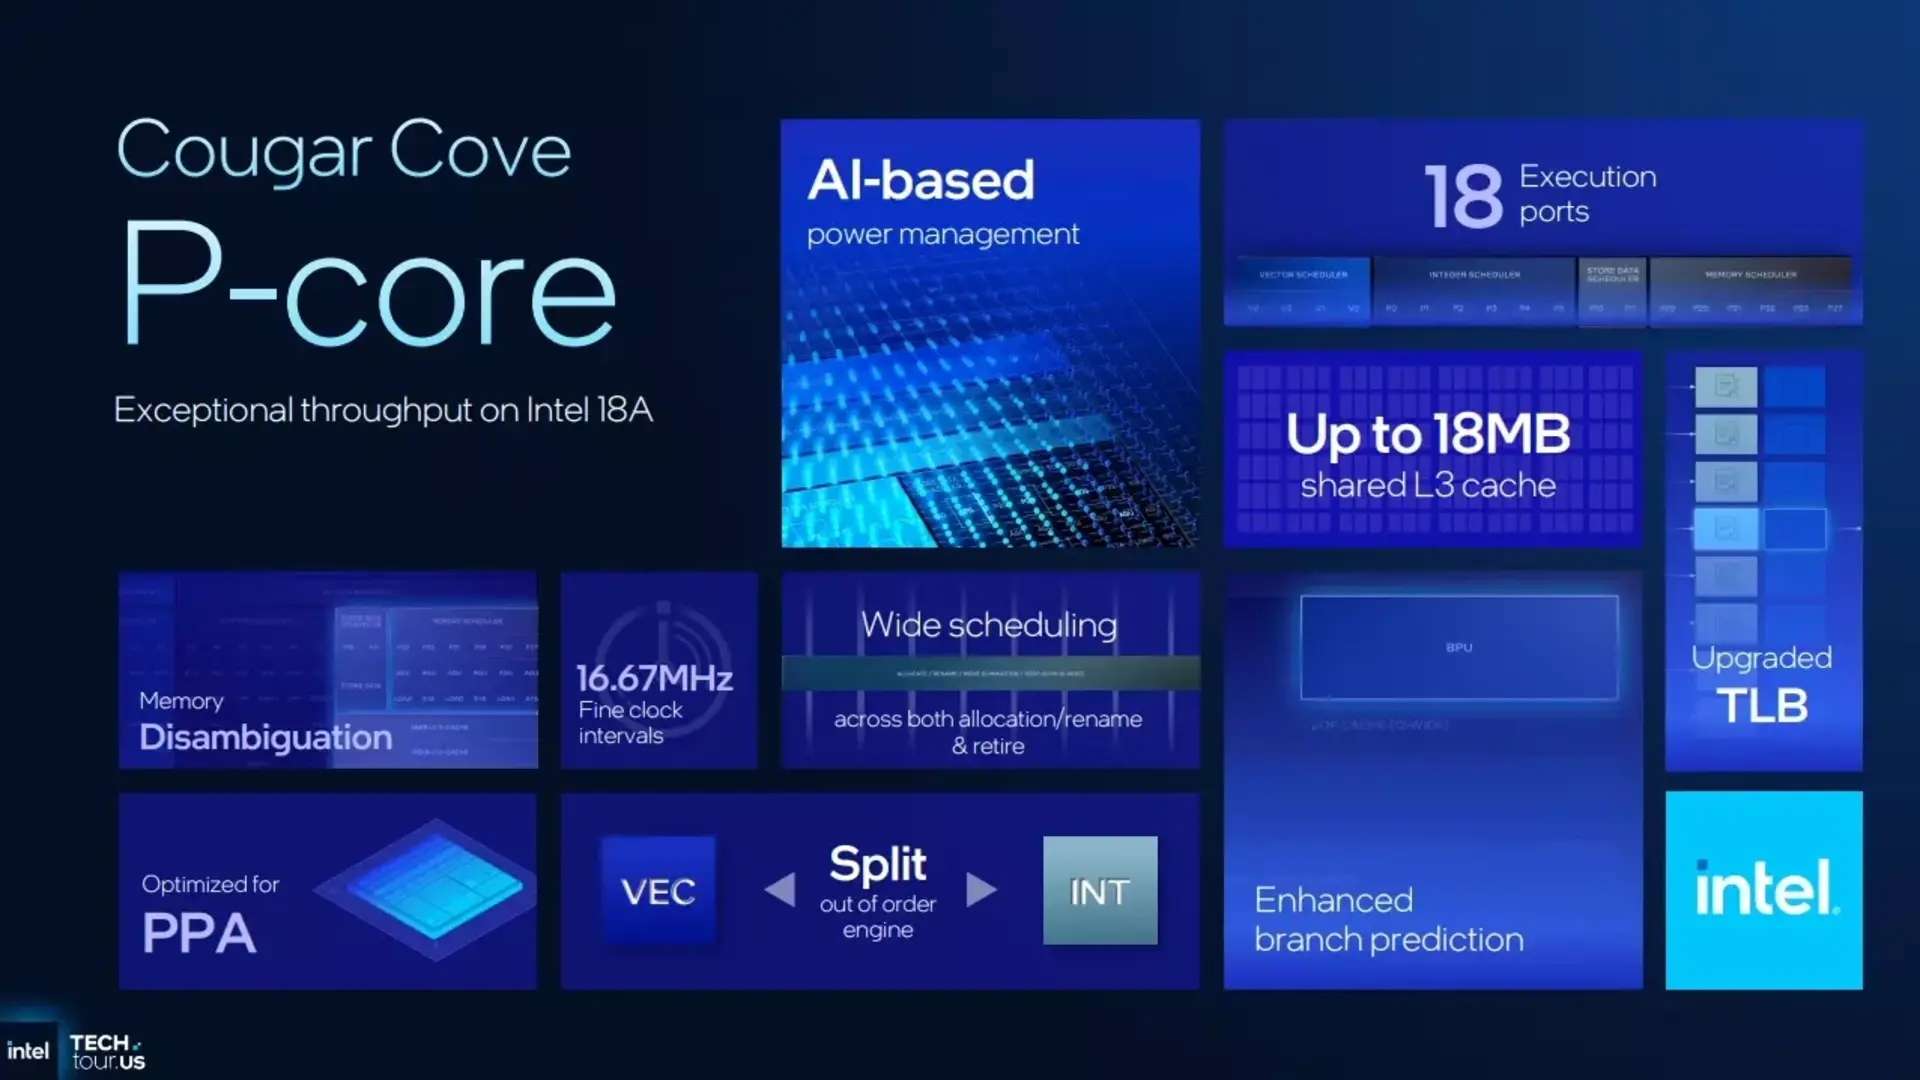
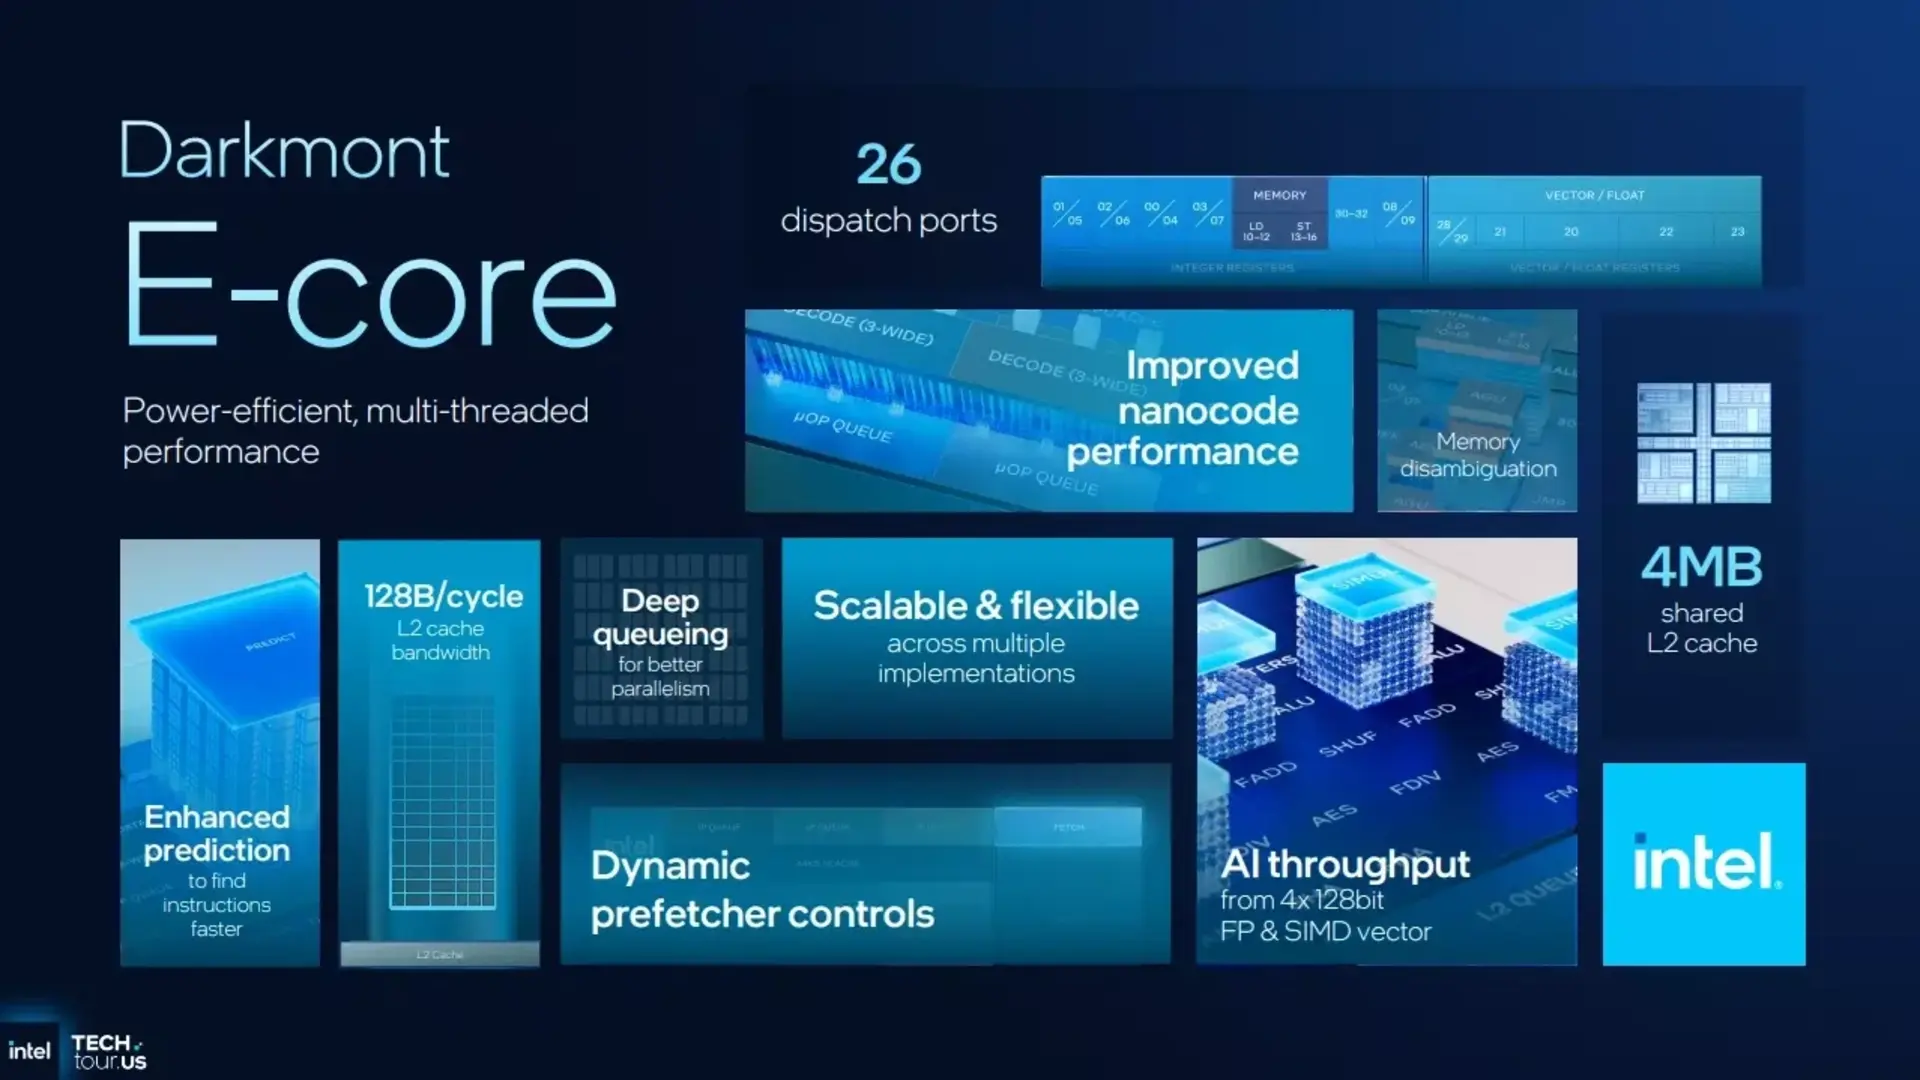
در نسلهای پیشین مانند Meteor Lake، هستههای P و E در تایل محاسباتی قرار داشتند، درحالیکه هستههای کممصرف LP-E در تایل جداگانهای بهنام SoC مستقر بودند. این جداسازی باعث میشد ارتباط LP-E با سایر هستهها به مسیرهای میانتایلی وابسته باشد و در نتیجه، تأخیر افزایش پیدا کند. در Panther Lake، این ساختار تغییر کرده است؛ هستههای LP-E به تایل محاسباتی منتقل شدهاند و در کنار هستههای P و E قرار گرفتهاند. از طرف دیگر، هستههای E نیز مانند هستههای P به حلقهی مشترک متصل به کش L3 با ظرفیت ۱۸ مگابایت دسترسی دارند. این حلقه، مسیر ارتباطی مشترکی میان هستهها و کش L3 ایجاد میکند و با کوتاهتر کردن مسیر دسترسی به کش مشترک، به کاهش تأخیر در تبادل داده میان هستهها کمک میکند. در نتیجه، هستههای مختلف میتوانند هماهنگتر و با سربار ارتباطی کمتری با یکدیگر کار کنند؛ مزیتی که بهویژه در پردازشهای چندهستهای و بارهای کاری سنگین اهمیت پیدا میکند.
یکی دیگر از نوآوریهای اینتل در این بخش، تعبیهی کش سمت حافظه یا Memory Side Cache (MSC) در تایل محاسباتی است. این حافظهی ۸ مگابایتی بهعنوان یک کش سطح سیستم عمل میکند و در خدمت بلوکهای غیر CPU نظیر شیدرهای گرافیکی، موتور هوش مصنوعی (NPU) و واحدهای ورودی/خروجی قرار دارد.
MSC دادههای پرتکرار را در نزدیکترین فاصلهی ممکن به واحدهای مصرفکننده نگه میدارد تا نیاز آنها به فراخوانی اطلاعات از حافظهی اصلی (RAM) به حداقل برسد. این استراتژی هوشمندانه، بهطور همزمان باعث کاهش مصرف انرژی، خلوت شدن ترافیک حافظه، آزادسازی پهنای باند و در نهایت، جهش ملموس در سرعت عملکرد GPU و NPU میشود.
تایل گرافیکی
گرافیک مجتمع Panther Lake بر پایهی معماری جدید Xe3 طراحی شده و با در اختیار داشتن حداکثر ۱۲ هستهی Xe و ۱۲ واحد ریتریسینگ، بلندپروازانهترین تلاش Intel در حوزهی iGPUها بهحساب میآید. این نسل نهتنها جایگزین مستقیم Xe2 در Lunar Lake میشود، بلکه از نظر عمق تغییرات معماری، میتوان آن را بزرگترین جهش تاریخ گرافیکهای مجتمع اینتل دانست.
مدل | تعداد هستههای Xe | بیشینهی فرکانس | توان محاسباتی (TOPS) | کاربری |
|---|---|---|---|---|
Arc B390 | ۱۲ | ۲٫۵ گیگاهرتز | ۱۲۲ | بازی و AI سنگین |
Arc B370 | ۱۰ | ۲٫۴ گیگاهرتز | ۹۸ | بازیهای سبک و کارهای گرافیکی متوسط |
Intel Graphics | ۴ | ۲٫۴۵ گیگاهرتز | ۴۰ | مالتیمدیا و ویرایش تصویر |
Intel Graphics | ۲ | ۲٫۳ گیگاهرتز | ۱۸ | باتری کممصرف و کارهای سبک |
انواع واحد پردازش گرافیکی یکپارچه در پردازندههای پنترلیک
در گرافیک مجتمع Panther Lake، اینتل با بازطراحی پایپلاین ریتریسینگ تلاش کرده یکی از گلوگاههای همیشگی رندر گرافیکی را برطرف کند. در نسلهای پیشین، محاسبات ریتریسینگ ناچار بودند در همان مسیر رندر کلاسیک اجرا شوند؛ مسیری که همزمان وظیفهی پردازش هندسه، شیدرها و خروجی تصویر را بر عهده داشت. این هممسیر بودن باعث میشد با سنگینتر شدن محاسبات نور و بازتابها، کل فرایند رندر دچار مکث و افت کارایی شود. در معماری Xe3، اینتل با جدا کردن پایپلاین ریتریسینگ و امکان اجرای غیرهمزمان آن، اجازه میدهد این محاسبات مستقل از مسیر اصلی رندر انجام شوند. نتیجهی این رویکرد، استفادهی یکنواختتر از منابع GPU و کاهش افتهای ناگهانی عملکرد در صحنههای سنگین خواهد بود.
هر واحد پردازشی در این معماری به هشت موتور برداری ۵۱۲ بیتی و هشت واحد ماتریسی XMX با پهنای ۲۰۴۸ بیت مجهز شده است؛ ترکیبی که نقش پررنگی در بهبود توان پردازشهای محاسباتی و وظایف مبتنی بر هوش مصنوعی ایفا میکند. در کنار این موارد، بهبود توزیع رجیسترها و بازنگری در زمانبندی شیدرها باعث شده تعداد تردهای قابل استفاده در هر اسلایس حدود ۲۵ درصد افزایش پیدا کند. همچنین ظرفیت ترکیبی کش L1 و حافظهی اشتراکی محلی (SLM) حدود ۳۳ درصد بیشتر شده تا GPU بتواند در بارهای سنگین، بدون افت محسوس کارایی به فعالیت خود ادامه دهد.
پنترلیک از تبدیل بازگشتی از دقت FP8 یا (FP8 dequantization) پشتیبانی میکند؛ به این ترتیب که GPU میتواند دادهها را ابتدا با دقت پایین FP8 ذخیره و جابهجا کند تا مصرف انرژی و فشار روی حافظه کاهش یابد، اما از آنجایی که FP8 از نظر دقت محدودیت دارد، در لحظهی انجام محاسبات این دادهها به قالب دقیقتر بازگردانده میشوند. این فرایند اجازه میدهد پردازشها هم سریعتر و کممصرفتر باشند و هم دقت مورد نیاز برای وظایف محاسباتی و هوش مصنوعی حفظ شده و در نتیجهی آن بهرهوری انرژی و کارایی پردازشی بهینه میشود.
پیشرفتهای پنترلیک بههمینجا ختم نمیشود و اینتل در پردازندههای Core Ultra Series 3 عملاً سه رکن اصلی پردازش مدرن (CPU، GPU و NPU) را بهصورت هدفمند و مکمل کنار هم قرار داده است تا مفهوم «AI PC» از شعار به واقعیت نزدیک شود. در بخش هوش مصنوعی، اینتل از معماری جدید NPU 5 رونمایی میکند؛ واحدی کممصرف که برای اجرای مداوم و پسزمینهای وظایف هوش مصنوعی طراحی شده و در مجموع کل سیستم، توان پردازشی تا ۵۰ تاپس (TOPS) را ارائه میدهد. هدف این NPU، اجرای پردازشهای AI بدون فشار به CPU و GPU و در نتیجه، افزایش محسوس شارژدهی باتری در لپتاپها است. در سوی دیگر، پردازندهی گرافیکی مجتمع مبتنی بر Intel Arc و معماری Xe3 قرار دارد که با حداکثر ۱۲ هستهی Xe و توان پردازشی تا ۱۲۰ TOPS، تمرکز ویژهای بر پردازشهای گرافیکی مدرن و شتابدهی هوش مصنوعی دارد.
علاوهبر این، اینتل با معرفی مجموعه قابلیتهای XeSS 3، قابلیت تولید فریم ۴ برابری (4x Frame Generation) را به دنیای گرافیکهای مجتمع آورده تا آنچه پیشتر در انحصار کارتهای گرافیک گرانقیمت دسکتاپ بود، حالا در بطن یک SoC کممصرف (۱۷ تا ۴۵ وات) جای بگیرد. بدینترتیب دیگر اجرای روان بازیهای AAA روی اولترابوکهای ظریف و کنسولهای دستی دیگر یک رویا نخواهد بود.
وقتی پای بررسیهای میدانی به میان میآید، عملکرد گرافیک مجتمع در پردازندهی پرچمدار Core Ultra X9 388H نشان میدهد که اینتل استراتژی خود را به شکلی هوشمندانه تغییر داده است. در اینجا دیگر تمرکز صرفاً روی افزایش اسمی قدرت شیدرها نیست؛ بلکه اولویت به «پایداری عملکرد» و «تجربهی روان گیمینگ» داده میشود.
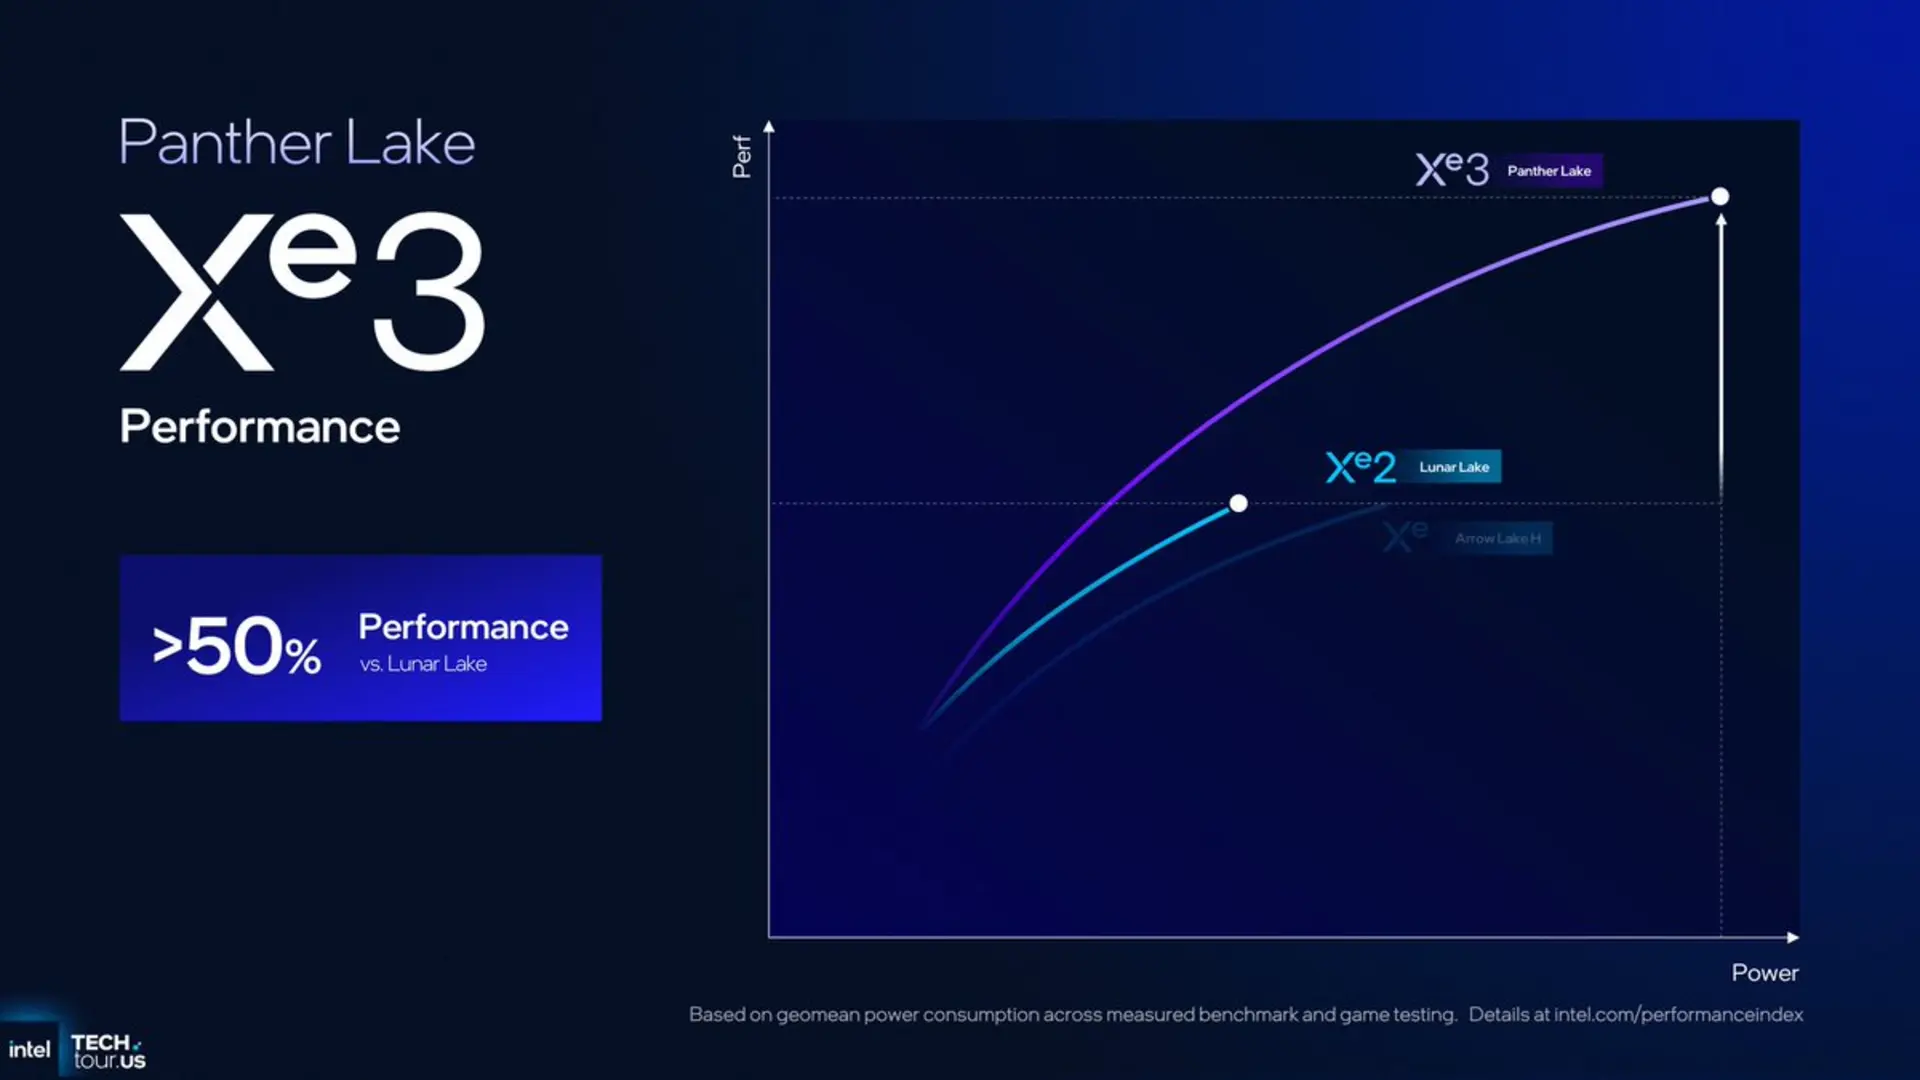
بر اساس دادهها و بنچمارکهای رسمی منتشرشده از سوی اینتل، در اجرای بازیهای سنگینی مثل Cyberpunk 2077، Hogwarts Legacy و Marvel's Spider-Man، گرافیک یکپارچهی Arc B390 نه تنها میانگین نرخ فریم را تا ۱۰ درصد ارتقا میدهد، بلکه شگفتی اصلی را در شاخص «کفِ فریمریت یا همان 1% Low» رقم میزند. بهبود ۲۵ درصدی در این شاخص به این معناست که آن افت فریمهای ناگهانی و آزاردهنده به حداقل رسیده، آن هم در حالیکه توان مصرفی تراشه با وسواس عجیبی در مرز ۱۷ وات کنترل میشود تا توازن میان قدرت و حرارت حفظ شود.
در جریان نمایشگاه CES 2026، نمایندهی کانال یوتوبی Geekerwan، فرصت این را داشت تا پلتفرم مرجع اینتل را با پردازندهی Core Ultra 9 388H مستقیماً به چالش بکشد. این بررسی میدانی که با استفاده از بازیهای شخصی روی حافظهی فلش انجام شد، حقایق جدیدی را فراتر از ادعاهای رسمی اینتل فاش کرد.
نتایج بهدستآمده در بازیهای سنگینی مثل Cyberpunk 2077 خیرهکننده بود. در حالیکه گرافیک مجتمع نسل قبل (258V) روی تنظیمات Medium و رزولوشن 1080P تنها ۳۹ فریم ارائه میداد، گرافیک Arc B390 توانست به نرخ ۶۷ فریم بر ثانیه دست یابد. این یعنی گرافیک مجتمع پنترلیک حالا رسماً وارد قلمرو کارتهای گرافیک مجزای اقتصادی شده و عملکردی مشابه با RTX 4050 شصت واتی یا حتی RTX 3060 هشتاد واتی را به نمایش میگذارد. در بازی Black Myth: Wukong نیز تفاوت عملکرد این iGPU با یک کارت گرافیک ۸۵ واتی ۴۰۵۰ بهطرز عجیبی کمرنگ شده بود.
خبر خوب این که این تراشه روی رزولوشن 2K (با کمک XeSS معمولی) توانسته بازیهای سنگین را روی ۶۰ تا ۷۰ فریم اجرا کند. این یعنی برای اولین بار، لپتاپهای باریک و سبک واقعاً میتوانند بازیهای AAA را در رزولوشن بالاتر از ۱۰۸۰p اجرا کنند.
اما نکتهی چالشبرانگیزی که اینتل در اسلایدهای خود به آن اشاره نکرده، هزینهی پردازشیِ سنگین قابلیت 4X multi-frame generation است. بررسیهای «گیکر ون» نشان داد که اگرچه روشن کردن این قابلیت در بازیهایی مثل سایبرپانک، عدد فریمریت را به ظاهر از ۶۰ به بالای ۱۶۰ فریم میرساند، اما این جهش بدون هزینه نیست. در واقع، حدود ۲۰ فریم از توانِ خالص GPU صرفاً برای «محاسبه و تولید فریمهای مصنوعی» هزینه میشود. به بیان سادهتر، فریم واقعی و پایهی بازی (Base Frame) با فعالسازی این قابلیت، از ۶۰ فریم به حدود ۴۰ فریم سقوط میکند. این موضوع باعث میشود که با وجود نمایش عددی بالا در فریمشمار، تجربهی بازی بهاندازهی یک نرخ فریم نیتیو (واقعی) روان نباشد و تاخیر ورودی افزایش یابد.
هارمونی سختافزار و نرمافزار
معماری هیبریدی و پیچیدهی پردازندههای پنتر لیک برای اینکه بتواند بهترین عملکرد را داشته باشد، به یک سیستم مدیریت یکپارچه نیاز دارد. اینتل در این نسل، ساختار نرمافزاری خود را از پایه بازطراحی کرده تا هماهنگی بین سختافزار و نرمافزار به بالاترین حد ممکن برسد. نقش اصلی در این میان بر عهدهی نسخهی دوم Intel Thread Director است. این سیستم بهطور پیوسته و در لحظه، رفتار برنامهها را زیر نظر میگیرد؛ پردازشهای سنگین را به هستههای قدرتمند (Cougar Cove) میفرستد و کارهای پسزمینه را به هستههای کممصرف میسپارد.
اما یکی از جذابترین تغییرات پنتر لیک، استفاده از روشی به نام زمانبندی بدون مرز (Zoneless Scheduling) است. در گذشته برنامهها به بخشهای خاصی از پردازنده محدود میشدند، اما حالا پردازشها میتوانند کاملاً آزادانه و شناور بین تمام هستهها جابهجا شوند. این انعطافپذیری بالا باعث میشود سیستم خیلی راحتتر با شوکهای پردازشی کنار بیاید. مخصوصاً زمانی که پردازندهی مرکزی و گرافیک بهطور همزمان در حال استفاده از نهایت توان خود هستند و بر سر مصرف برق و دفع حرارت رقابت میکنند، این زمانبندی شناور به توزیع منطقیتر انرژی کمک بزرگی میکند.
از طرف دیگر، اینتل با معرفی فناوری جدیدی به اسم بهینهساز هوشمند تجربه کاربری، رسماً به عمر پروفایلهای ثابت و تکراری باتری مثل حالتهای Balanced یا Performance پایان داده است. سیستم حالا با دریافت دادههای لحظهای، فرکانس و ولتاژ تکتک هستهها را بهصورت پیوسته تغییر میدهد. به زبان ساده، لپتاپ شما میتواند بدون نیاز به هیچ تنظیمات دستی، در کسری از ثانیه از یک دستگاه کاملاً بیصدا به یک سیستم قدرتمند تبدیل شود. طبق ادعای اینتل، همین مدیریت هوشمند باعث شده تا عملکرد پنتر لیک در کارهای روزمره و بنچمارک Cinebench تا ۱۹ درصد نسبت به پروفایلهای انرژی ثابت ارتقا پیدا کند.
این بهینهسازیها در دنیای گیمینگ هم حسابی به چشم میآیند. در بازیهای امروزی که معمولاً فشار اصلی روی کارت گرافیک خواهد بود، درگیری بیش از حد پردازندهی مرکزی فقط باعث داغ شدن بیمورد سیستم میشود. برای حل این مشکل اینتل در پنترلیک از الگوریتم هوشمندانهی «اول هستههای کممصرف» (E-cores-first) استفاده میکند تا بخشی از وظایف پردازنده ابتدا روی هستههای E اجرا شود و توان و ظرفیت بیشتری برای گرافیک باقی بماند. همین ترفند بهظاهر ساده است که جلوی افت فریمها را میگیرد و خروجی تصویر بسیار پایدارتر و روانتری را به گیمر تحویل میدهد.
در نهایت، پنتر لیک ثابت میکند که دوران تکیه کردن فقط به قدرت خام سختافزاری گذشته است. این پردازنده حالا به سیستمی تبدیل شده که خودش در لحظه تصمیم میگیرد کدام هستهها را روشن کند، ولتاژ را چطور تنظیم کند و توان مصرفی را چطور بین CPU و گرافیک تقسیم کند. این هارمونی دقیق بین سختافزار و نرمافزار، دقیقاً همان چیزی است که پتانسیل واقعی لیتوگرافی پیشرفتهی 18A اینتل را در استفادهی روزمره آزاد میکند.
انواع پردازندههای پنترلیک
برای جلوگیری از سردرگمی هنگام خرید لپتاپ با پردازندههای Core Ultra نسل سوم، باید پیش از هر چیز منطق نامگذاری تازهی اینتل را بشناسیم. اینتل در Panther Lake، رویکرد قدیمی رتبهبندی صرفاً عددی را کنار گذاشته و نام پردازندهها را بر اساس نوع کاربری، نقش گرافیک مجتمع و ساختار کلی لپتاپ تعریف میکند. بههمیندلیل، وقتی به پیشوندها و اعداد انتهایی نام پردازنده دقت کنیم، میتوان فهمید این تراشه برای چه نوع سیستمی طراحی شده، تا چه حد به گرافیک مجتمع و رم سیستم متکی است و دقیقاً چه انتظاری باید از آن داشت.
در این نسل، بخشی از پردازندهها با پیشوند جدید X معرفی شدهاند؛ مدلهایی که به قدرتمندترین پیکربندی گرافیک مجتمع Panther Lake، یعنی Arc B390، مجهز هستند و بیشتر برای لپتاپهایی در نظر گرفته شدهاند که به کارت گرافیک مجزا نیاز ندارند. از آنجا که گرافیک مجتمع برای ذخیره و پردازش دادههای گرافیکی از حافظهی اصلی سیستم استفاده میکند، سرعت و پهنای باند رم تأثیر مستقیمی بر عملکرد آن دارند. به همین دلیل، در مدلهای مجهز به گرافیک قدرتمندتر، استفاده از حافظهی سریع با پهنای باند بالا اهمیت ویژهای پیدا میکند و میتواند به گرافیک مجتمع اجازه دهد بخش بیشتری از توان خود را به نمایش بگذارد.
در مقابل، مدلهایی قرار دارند که پیشوند X ندارند و معمولاً با عدد ۶ در انتهای نام خود شناخته میشوند. این پردازندهها بیشتر برای لپتاپهایی طراحی شدهاند که در کنار آنها از کارت گرافیک مجزا استفاده میشود؛ بنابراین در چنین سیستمهایی، بخش عمدهی پردازشهای گرافیکی بر عهدهی GPU مستقل و حافظهی اختصاصی آن خواهد بود. به همین دلیل، این مدلها به گرافیک مجتمع قدرتمندتری نیاز ندارند و اینتل بخشی از منابع تراشه را به جای iGPU، صرف بخشهای دیگری مانند توان پردازشی CPU و بهرهوری انرژی کرده است.
در پایینترین سطح این خانواده، پردازندههایی قرار میگیرند که با اعداد انتهایی ۵ یا ۲ شناخته میشوند و برای لپتاپهای اقتصادی، اداری و دانشجویی در نظر گرفته شدهاند. این مدلها با توان مصرفی پایینتر و گرافیک مجتمع سادهتر، بیش از هر چیز روی شارژدهی باتری، پایداری عملکرد و پاسخگویی مناسب در استفادههای روزمره تمرکز دارند. در چنین لپتاپهایی معمولاً خبری از پردازشهای گرافیکی سنگین نیست و نیازی به حافظهی رم بسیار پرظرفیت و پرسرعت نیز وجود ندارد؛ بنابراین این پردازندهها میتوانند برای کاربرانی که لپتاپ را عمدتاً برای وبگردی، کارهای اداری، تماشای محتوا و استفادههای روزمره میخواهند، گزینهی متناسبی باشند.
سایهی سنگین اپل؛ پاشنهآشیل تکهستهای همچنان پابرجاست
با وجود تمام این دستاوردهای شگرف در بهرهوری انرژی و قدرت گرافیکی، نگاهی واقعبینانه به بنچمارکها نشان میدهد که پنترلیک هنوز نتوانسته تمام قلعههای رقبا را فتح کند. بررسیهای موشکافانهی رسانههایی همچون Tom's Guide، پرده از واقعیتی تلخ برای تیم آبی برمیدارد: اینتل همچنان در نبرد «پردازش تکهستهای» در برابر تراشهی M5 اپل، قافیه را میبازد.
درحالیکه معماری جدید اینتل در پردازشهای چندهستهای فاصلهی خود را با تراشههای ردهبالای اپل به حداقل میرساند (بهطوریکه پرچمدار X9 388H تنها حدود ۱۴ درصد ضعیفتر از M4 Pro عمل میکند) اما در پردازشهای تکهستهای، شرایط بهگونهای کاملا متفاوت پیش میرود و در این بخش، تراشهی پایهی M5 اپل همچنان بیرقیب ظاهر میشود و عملاً میدان را در اختیار دارد. در واقع، بررسیها نشان میدهد که اینتل کمترین میزان پیشرفت نسلی خود را دقیقاً در عملکرد تکهستهای تجربه میکند و این یعنی مکبوکهای مجهز به پردازندهی M5 در باز شدن سریع برنامهها تا اجرای روان کدهای جاوا اسکریپت در وبگردیهای سنگین تا ۳۰ درصد چابکتر از رقیب اینتلی عمل میکنند.
پردازنده | Geekbench 6 CPU | Steel Nomad | Solar Bay |
|---|---|---|---|
Intel Core Ultra X9-388H (Panther Lake) | ۳۰۳۱ ۱۷۲۸۳ | ۱۴۸۳ | ۲۶۵۸۹ ۱۰۱ فریمبرثانیه |
Apple M5 | ۴۲۸۸ ۱۷۹۲۶ | ۱۱۲۲ | ۲۳۹۵۰ ۹۰٫۴ فریمبرثانیه |
منبع: Tom's Guid
پنترلیک؛ همان پردازندهای که اینتل نیاز داشت
در نهایت، Panther Lake را میتوان یکی از مهمترین تلاشهای اینتل برای خروج از چالشهای سالهای اخیر و بازتعریف مسیر پردازندههای x86 دانست. اینتل با این نسل نشان میدهد که ترکیب عملکرد بالا و مصرف بهینهی انرژی لزوماً یک تضاد فنی نیست. بهرهگیری از فناوری ساخت Intel 18A در کنار بهینهسازی معماری هستهها، مدیریت بهتر مصرف انرژی و بهبود ارتباط میان بخشهای مختلف تراشه، از عوامل اصلی افزایش بهرهوری انرژی در Panther Lake به شمار میروند و به اینتل کمک میکنند فاصلهی خود را با رقبا در زمینهی عملکرد بهازای مصرف انرژی کاهش دهد.
البته وقتی عملکرد Panther Lake را در برابر تراشههای پرچمدار M5 Pro و M5 Max قرار میدهیم، مشخص میشود که اینتل هنوز برای رقابت در بالاترین سطح با تراشههای ردهبالای اپل فاصله دارد. بااینحال، اهمیت Panther Lake بیش از آنکه در نتیجهی یک مقایسهی مستقیم خلاصه شود، در مسیری است که اینتل برای بهبود همزمان عملکرد و بهرهوری انرژی در نسلهای جدید پردازندههای خود در پیش گرفته است.